タグ: Enterprise AI

  • 人数で課金する会社は、人を減らすAIをどう売るのか——Workdayの年次報告書が書き換えた成長の前提

    人数で課金する会社は、人を減らすAIをどう売るのか——Workdayの年次報告書が書き換えた成長の前提

    人数で課金する会社は、人を減らすAIをどう売るのか——Workdayの年次報告書が書き換えた成長の前提

    はじめに:人件費を減らすAIと、人数で決まる売上

    企業向けのAIは、多くの場合「人の仕事を肩代わりする」ことを価値として売られる。採用の書類選考、経費の確認、問い合わせへの一次回答。AIがこなす仕事が増えるほど、顧客企業はその仕事に充てていた人件費を減らせる、という説明である。

    では、顧客企業の従業員数に応じて料金を受け取っている会社が、このAIを売るとどうなるか。

    人事・財務の業務ソフトウェアを提供するWorkdayは、まさにその位置にいる。同社の売上は、顧客企業で働く人の数に連動する。そして同社の経営陣は、AIの価値を顧客の人件費と比べて説明している。製品が約束する価値と、売上が決まる仕組みが、逆を向いている。

    本稿は、この向きの違いが同社を不利にするかどうかを判定するものではない。代わりに、同社が米国証券取引委員会(SEC)に提出してきた年次報告書(10-K)と四半期報告書(10-Q)の文言の変化を追う。そこから見えてくるのは、人数で稼ぐ会社にとってのAIの論点は、競合の出現よりも先に、顧客が人を増やさなくなることにある、という構図である。しかも同社にとってその問題は、AIより先にやってきていた。

    1. 売上は「顧客の従業員数」で決まる

    Workdayは、人事(採用、給与、評価、人員配置)と財務(会計、支出管理)の業務を担うクラウドソフトウェアの会社で、顧客は1万1,500社を超える。売上の大半はサブスクリプション(継続課金)である。

    その料金の決まり方を、同社は10-Kで次のように説明している。

    our subscription-based model is largely based on the size of our customers’ employee headcount(当社のサブスクリプション・モデルは、概ね顧客の従業員数の規模にもとづいている)

    ここで区別しておきたいのは、この「人数」がソフトウェアを使う人の数ではないことだ。AIと企業向けソフトウェアの議論では、「AIが画面操作を肩代わりすれば、利用者の席が減る」という話になりがちである。しかし人事のソフトウェアが数えるのは、給与を払われ、評価され、配置される人、つまり顧客企業に雇われている人である。画面を誰が操作するかとは関係がない。

    したがって、AIがWorkdayの売上に効く経路は「利用」ではなく、顧客企業の雇用の判断を通る。AIが同社の画面操作を代行しても、課金の母数は減らない。減るのは、顧客企業が人を減らしたとき、あるいは増やさなくなったときである。

    2. 人数の問題は、AIより先にやってきた

    この経路は、すでに一度、実際に効いている。原因はAIではなかった。

    2024年5月、Workdayは通期のサブスクリプション売上の見通しを引き下げた。同月の10-Qは、成長率の鈍化の要因の一つに「既存顧客の更新時における、従業員数の契約水準の低下」を挙げている。決算説明会で最高財務責任者(CFO)は、引き下げ幅のおよそ半分をこの要因によるものと説明した(説明会の書き起こしによる)。顧客の従業員数の伸びが、想定より鈍かったのである。

    その後、10-Kの書き方も変わった。2024年には「影響を与えうる」と書かれていた顧客の人員減のリスクが、2025年には「実際に影響を与えてきた」に変わった。さらに、顧客が更新時に「より少ない従業員数で」契約する可能性も明記された。

    ここまでの記述のどこにも、AIは原因として書かれていない。人数の減少は、景気や顧客の事業環境の結果として説明されている。AIの話が始まる前に、人数で課金するモデルの弱点はすでに表に出ていた。

    3. 成長の前提から「人数の増加」が消えた

    もっと重要なのは、リスクの書き方ではない。Workday自身が「何で成長する会社なのか」の説明を変えたことだ。

    2024年12月の10-Qまで、Workdayは既存顧客からの成長の源泉を次のように説明していた。

    expanding our footprint with existing customers through product add-ons, increased headcount level commitments, and price adjustments(追加製品、従業員数の契約水準の引き上げ、価格改定を通じて既存顧客での存在感を広げる)

    ところが2025年3月の10-Kから、同じ位置の文はこう変わった。

    expanding our relationships with existing customers through increased adoption of our suite of solutions(製品群の採用拡大を通じて既存顧客との関係を広げる)

    「顧客の人数が増えること」が、成長の源泉の一覧から外れた。

    人数で課金するモデルには、本来、組み込みの追い風がある。顧客企業が成長して人を雇えば、Workdayが何もしなくても売上が増える。顧客の成長と自社の成長が、従業員数という一本の線でつながっているからだ。同社はその追い風を、成長の前提として数えるのをやめた。代わりに置かれたのは、同じ顧客に、より多くの製品を使ってもらうことである。

    この書き換えの理由を、同社は説明していない。ただ、時期は示唆的である。2024年に人数の要因で見通しを引き下げた後であり、AIによる業務の代替が広く語られ始めた時期とも重なる。顧客の人数は、もはや当てにできる成長の源ではない。そうした前提で、成長の組み立てを移し始めたと読むことはできる。

    4. 人数の上に「仕事の量」を積む

    製品群の採用拡大の中心に置かれているのが、AIである。そしてAIについて、同社は人数とは別の料金の単位を用意した。

    2025年9月に導入した「Flex Credits」は、年単位で購入したクレジットを、AIが行った作業の回数に応じて消費する仕組みである。同社の製品ページは、なぜ従来の従業員数ベースではないのかという問いに、こう答えている。

    Flex Credits charge for the work AI completes on your behalf, not the number of employees in your organization.(Flex Creditsは、AIが代わりに完了した仕事に課金するのであって、組織の従業員数に課金するのではない)

    人数と切り離された単位を持てば、顧客が人を増やさなくても、AIが仕事をこなすほど売上が増える道ができる。人件費を減らすAIを売りながら、減った人件費の一部をソフトウェアの売上として受け取る仕組みである。実際、経営陣は決算説明会で、AIの事業機会をソフトウェアへの支出ではなく、顧客がその業務に払っている人件費と比べて見積もっていると述べた(2026年8月、説明会の書き起こしによる)。

    ただし、これは人数の課金を置き換えたものではない。中核の人事・財務の製品は、最新の10-Qでも従業員数ベースのままである。10-KはFlex Creditsを「一部のAIソリューション」向けの料金と限定し、その価格設定について「経験が限られている」ことをリスクとして新たに挙げた。人数の単位の上に、仕事の量の単位が積まれた、二階建ての形である。

    さらにWorkdayは、人だけでなくAIエージェントの権限まで管理する方向に進んでいる。2026年10月に発表した買収の発表文は、「すべての入社、異動、退職はWorkdayの出来事だ」と書いた。誰が働いているかの記録を持つ会社が、AIエージェントという新しい「働き手」の記録まで持とうとしているとも読める。ただし、それをどう収益化するかはまだ明らかではない。

    5. まだ分からないこと

    ここまでの事実から、人数で課金するモデルがAIによって崩れつつある、と結論するのは早い。

    まず、顧客の従業員数は、現時点では減っていない。2026年5月の決算説明会でCFOは、テクノロジー業界での減少は他の業界の増加で相殺されており、顧客の人数は「ほぼ横ばい」で、売上成長にとって大きな要因ではないと説明した。最高経営責任者(CEO)は、仮に人数が減るとしても「AIが置き換えているのは人であって、ソフトウェアではない」と述べている(いずれも説明会の書き起こしによる)。

    次に、提出書類は、顧客の人員減とAIを因果で結んでいない。人数が伸びない理由がAIなのか、景気なのか、業界ごとの事情なのかは、公表資料からは切り分けられない。仕事の量の課金が、人数の課金の伸び悩みをどこまで補えるのかも、開示からはまだ確かめられない。

    おわりに:顧客の成長と自社の成長を、何で結ぶのか

    タイトルの問いに戻る。人数で課金する会社は、人を減らすAIをどう売るのか。

    Workdayの開示が示しているのは、人数の課金を捨てるのでも、守り抜くのでもない道である。中核の料金は顧客の従業員数のまま残し、その上に、AIがこなした仕事の量で払う単位を積む。そして成長の前提からは、顧客の人数が増えることを外した。同社の売上はこれから、顧客企業の雇用の判断と、AIに任せる仕事の量という、二つの異なる意思決定に連動していくことになる。

    人数に連動して売る事業者は、人事に限らない。従業員数や拠点数、契約者数といった、顧客の側の「規模」を課金の母数にしているソフトウェアは多い。そうした事業者にとってAIの最大の論点は、AIを持つ競合が現れることよりも先に、顧客が規模を増やさなくなることかもしれない。

    AIは競争環境を変えるだけではない。顧客の成長と自社の売上の結びつきそのものを変える。AI時代の価格設計で問われるのは、「AIにいくら課金するか」だけではない。顧客の成長と自社の成長を、これから何によって結びつけるのかである。


    Disclaimer

    本稿は、同社の公表資料および公開報道にもとづく独立した分析であり、特定の組織の公式見解ではありません。

    本稿は特定の証券の売買を推奨するものではなく、投資助言・投資勧誘ではありません。 将来の株価、企業価値の割高・割安、投資判断に関する見解を示すものではありません。

    本稿の記述は、決算発表資料、SECへの提出書類、同社のプレスリリースおよび公開ドキュメント、決算説明会の公開記録、ならびに公開報道の範囲に限られます。決算説明会の発言は第三者が作成した書き起こしにもとづきます。内部情報には一切依拠していません。

    筆者は JAPAN AI 株式会社および株式会社ジーニーに所属しますが、本稿は Alpha Beyond Frontier における筆者個人の独立した分析であり、所属各社の公式見解を示すものではありません。本稿は特定の企業の優劣を論じるものではありません。

    記載した数値および事実は、各出典の公表時点のものです。

    References

    本ブログの関連記事

  • AIが仕事を実行するとき、価値はどこに残るのか——ServiceNowが年次報告書に書いた強みと脆さ

    AIが仕事を実行するとき、価値はどこに残るのか——ServiceNowが年次報告書に書いた強みと脆さ

    AIが仕事を実行するとき、価値はどこに残るのか——ServiceNowが年次報告書に書いた強みと脆さ

    はじめに:好決算でも株価が下がった会社

    2026年1月29日、企業向けソフトウェアのServiceNowの株価は約10%下落した。前日に発表した四半期決算は、市場予想を上回っていた。報道はこの下落を、AIが既存のソフトウェアの事業モデルを覆すのではないかという懸念と結びつけた。AIが人に代わって業務をこなすようになれば、人が画面を操作するためのソフトウェアは要らなくなる、という筋書きである。

    本稿はこの筋書きの当否を判定するものではない。代わりに、少し手前の問いを立てる。AIが答えるだけでなく業務を実行するようになったとき、企業の競争力はどこに生まれるのか。

    ServiceNowの公表資料を追うと、ひとつの答えが見えてくる。競争力は「賢い答えを出すこと」から、「誰が何を実行してよいかを決め、記録し、必要なら止められること」へ移りつつある。言い換えれば、価値が残るのはAIに何をさせてよいかを決める場所である。ただし、その場所を最終的に誰が握るのかは、まだ決まっていない。そして同社自身が、そのことを年次報告書に書いている。

    1. どんな会社か:業務フローの基盤から「AIの司令塔」へ

    ServiceNowは、企業の社内業務の流れを管理するソフトウェアを提供している。IT部門の障害対応や問い合わせ対応から始まり、人事、カスタマーサービス、セキュリティ、リスク管理へと対象を広げてきた。社員の依頼を受け付け、承認者に回し、担当者を割り当て、期限を管理し、結果を記録する。こうした手順を、部門をまたいで一つの基盤の上で動かすのが同社の事業の骨格である。

    同社が自らをどう説明しているかは、この2年で大きく変わった。決算発表の冒頭に置かれる自己紹介は、2024年4月までは「デジタル・ワークフローの会社」だった。2024年7月からは「ビジネス変革のためのAIプラットフォーム」になり、2026年1月からは「ビジネス再創造のためのAIの司令塔(AI control tower)」になっている。

    法定開示も同じ方向に動いている。2026年4〜6月期の四半期報告書(10-Q)では、事業説明の冒頭が「組織がAIを統治し、保護し、管理することを支援する」となり、「業務フローのデジタル化」は2番目に置かれた。

    AIの数字も示されている。同社は2026年4〜6月期に、AI関連の年間契約額が10億ドルを超えたと発表した。2030年までに年間契約額の30%をAIから得るという長期目標も掲げている。ただし、この「AIの年間契約額」に何が含まれるのかの定義は、公表資料には見当たらない。法定開示の主要指標にも、AI専用の項目は置かれていない。

    2. 同じ年次報告書に書かれた、強みと脆さ

    本稿の出発点は、2026年1月に提出された2025年度の年次報告書(10-K)である。前年までの年次報告書になかった段落が、二つの場所に新しく書き加えられている。

    一つは事業の説明の部分で、AIの限界について次のように書いている。

    AIモデルは、パターンを見つけ、推奨を示し、洞察を引き出すことはできる。しかし、取引を独力で実行すること、承認を回すこと、記録システムを更新すること、業務ルールや規制要件の遵守を支えることはできない。

    続けて同社は、情報が生成された「後に起きること」を方向づけ、管理し、統制する能力こそが、企業がAIを導入するときに求める価値の大部分を占める、と述べる。そして、企業に必要なのは既存の業務フローを置き換える仕組みではなく、それと統合する仕組みだとしている。

    もう一つはリスク要因の部分である。同じ報告書には、次の趣旨の記述が新しく入った。

    当社の基盤と連携している製品の提供企業は、特定の連携やデータへのアクセスを遮断し、制限し、または料金を課すことによって、当社と競争しようとする可能性がある。クラウド型の事業者やAIネイティブの事業者が、当社の製品と競合する業務アプリケーションやAIによる自動化の仕組みをさらに構築する可能性もある。

    前者は、次のような主張である。AIがどれだけ賢くなっても、実際に仕事をするときには、権限を確かめ、承認を回し、記録を残し、問題があれば止める、という仕組みを通らなければならない。そして、AIが実際に仕事をする段階では、この仕組みにも大きな価値が生まれる。冒頭で「AIに何をさせてよいかを決める場所」と呼んだのは、この仕組みのことである。後者は、「その仕組みに至る接続は他社に握られうるし、同じ仕組みを別の事業者が作りうる」という認識である。

    同じ文書のなかに、自社の強みの根拠と、その強みが崩れうる経路が、同じ年に並んで書き加えられた。開示を読む立場から見ると、これは会社が自らの競争力の所在をどこに置いたかを示す、かなり率直な記述である。

    3. AIは、人間のために作られた権限の上で動く

    では、AIに何をさせてよいかは、実際にはどのように決まっているのか。同社の製品設計を見ると、AIエージェントは新しい仕組みの上で動いているのではなく、人間の社員のために作られてきた権限の体系の上で動いていることがわかる。

    同社の社員がユーザーコミュニティで解説している設定方法によると、AIエージェントを動かすとき、企業は二つの選択肢から選ぶ。一つは、エージェントを呼び出した社員の権限をそのまま引き継がせる方法で、これが初期設定になっている。この場合、エージェントはその社員が見られない記録を見ることも、実行できない処理を実行することもできない。もう一つは、エージェント専用のアカウントを用意し、必要な権限だけを与える方法である。社員から引き継ぐ権限を一部に限定することもできる。重要な操作については、人間の確認を経てから実行させることもできる。

    つまり、AIエージェントが何をしてよいかは、AIの性能ではなく、企業がこれまで社員に対して決めてきた「誰が何にアクセスし、何を承認できるか」という取り決めによって決まる。AIは既存の業務システムを置き換えるのではなく、その権限の体系を借りて動いている。

    同社の最近の買収も、この層に向かっている。2026年3月には、約12億ドルでVezaを買収した。四半期報告書は、買収の目的を、組織が重要なデータ、アプリケーション、システム、AIに対して「誰が、そして何がアクセスできるか」を把握し統制できるようにすることだと説明している。ここでの「何が」には、人間ではないAIエージェントが含まれる。その前の2025年12月には、社員の依頼を受け付ける入口となる対話型エージェントと社内検索の技術を持つMoveworksの買収を完了している。

    入口で依頼を受け、権限を確かめ、承認を回し、実行し、記録する。同社が手を伸ばしているのは、この一連の流れの全体である。

    4. 囲い込むのではなく、通り道になる

    ここまでなら、既存の業務ソフトウェア企業が自社の領域を守ろうとしている、という話に見える。しかし同社が2026年5月に発表した仕組みは、その見方とは逆の方向を向いている。

    同社は「Action Fabric」と呼ぶ仕組みで、自社の業務基盤を、社外のAIエージェントにも開放した。発表文は、対象を「ServiceNow上で作られたものであれ、Claude、Copilot、あるいは顧客が自ら開発したエージェントであれ、あらゆるAIエージェント」としている。社外のエージェントは、AIと外部のツールをつなぐ公開の接続規格(MCP)を通じて、顧客が同社の基盤上に作り込んできた業務フロー、承認の経路、業務ルールを呼び出せる。例として挙げられているのは、社員がチャットのなかでAIに頼んだパスワードの再設定や、新しい役割に必要な権限の申請が、同社の承認経路を通って処理される流れである。

    同じ日には、Microsoftとの提携拡大も発表した。Microsoftが提供するAIエージェント群にも、同社の統制の仕組みを広げるという内容である。

    発表文で同社は、接続規格そのものは公開されたもので、多くの企業向けソフトウェア事業者が対応していることを認めている。そのうえで、差は「データを読み書きできること」ではなく、「統制された業務を実行できること」にあると述べる。社外のエージェントによる操作も、すべて同社の統制の仕組みを通り、本人確認と権限の範囲の確認を経て、監査可能な記録として残る、という説明である。

    AIエージェントの入口を自社で囲い込むのではなく、どのエージェントから来た依頼であっても、実行する前に必ず通る場所になろうとしている。前章で見た「権限の体系を借りて動く」という構造を、自社の外にまで広げた形である。

    ここに同社の競争戦略がよく表れている。同社が狙っているのは、一番賢いAIになることではない。どのAIを使っても、仕事を実行するときには必ず通る場所になることである。どのAIが選ばれても、そのAIが企業のなかで仕事をするたびに同社の仕組みを通るのであれば、AIの性能競争の勝敗とは別のところに事業の足場を置くことができる。公表資料から読み取れる同社の構想は、そういう形をしている。

    5. その場所は、まだ誰のものとも決まっていない

    ただし、ここから「ServiceNowがこの場所を押さえる」と結論することはできない。AIに何をさせてよいかを決める場所が重要になるとしても、それを一社が独占できるとは限らない。

    まず、モデル企業も同じ方向へ進み始めている。OpenAIは企業向けのエージェント製品「Presence」を発表し、その発表文で、AIを本番の業務に使うには「モデル以上のものが必要だ」と書いた。エージェントに何をさせてよいか、いつ承認が要るか、いつ人に引き継ぐかを企業が決める設計で、対象業務の例には社員のIT関連の依頼への対応も挙がっている。

    また、同社が社外のエージェントを呼び込むために使う公開の接続規格は、顧客が別の基盤へ乗り換える手間を減らす方向にも働きうる。そして、同社自身が年次報告書のリスク要因に、連携先による接続の遮断や課金、AIネイティブの事業者や顧客の自社開発との競合を書いている。

    変化の方向ははっきりしているが、その場所の持ち主はまだ決まっていない。AIエージェントは既存の権限の上に積み重なる形で広がっている。しかし、その一番上を、既存のソフトウェア企業が取るのか、モデル企業が取るのか、顧客自身が取るのかは、決着していない。

    6. AIに仕事を任せるとき、何を確かめるべきか

    この観察は、AIを導入する側の企業にとっても意味を持つ。Deloitteの2026年の調査では、2年以内にエージェント型AIの導入を計画する企業が4分の3近くにのぼる一方で、エージェントを統治する成熟した仕組みを持つ企業は21%にとどまった。導入は進んでいるが、AIに何をさせてよいかを決める仕組みの整備は追いついていない。

    AIに業務を任せる企業にとって、問うべきことは「どのAIが最も賢いか」だけではない。少なくとも次の三つを確かめる必要がある。

    • AIエージェントは、誰の権限で動くのか。社員の権限を引き継ぐのか、専用の権限を持つのか
    • AIエージェントが実行したことは、どこに、誰が確認できる形で記録されるのか
    • 問題が起きたとき、誰が、どこで止められるのか

    これらの答えがある場所に、AIに仕事を任せるときの責任が集まる。そして、責任が集まる場所に、企業が長く対価を払い続ける理由が生まれる。ServiceNowの開示が示しているのは、同社がその場所に事業の重心を移そうとしていることである。

    おわりに:価値は、AIに何をさせてよいかを決める場所に残る

    AIがより賢くなれば、それを提供する企業の価値も高まる、と考えたくなる。しかし、AIが業務を実行する段階に入ると、価値の一部は別の場所に移る。

    タイトルの問いに答えるなら、AIが仕事を実行する時代に価値が残るのは、AIそのものだけではなく、AIに何をさせてよいかを決める場所である。誰の権限で動かし、何を記録し、どこで止めるか。この役割は、AIの性能とは別のところにある。

    ServiceNowは、その場所に賭けた。そして同じ年次報告書のなかで、その場所が他社に取られうることも書いた。その場所を最終的に誰が握るのかは、まだわからない。ただ、それを見極めるために見るべきものははっきりしている。各社のAIが「何ができるか」ではなく、「何をさせてよいかを、誰がどう決められるようにしているか」である。

    Disclaimer

    本稿は、同社の公表資料および公開報道にもとづく独立した分析であり、特定の組織の公式見解ではありません。

    本稿は特定の証券の売買を推奨するものではなく、投資助言・投資勧誘ではありません。 将来の株価、企業価値の割高・割安、投資判断に関する見解を示すものではありません。本稿で触れた過去の株価の動きは報道された事実の紹介であり、その原因を断定するものではありません。

    本稿の記述は、決算発表資料、SECへの提出書類、同社のプレスリリースおよび公開ドキュメント、ならびに公開報道の範囲に限られます。内部情報には一切依拠していません。

    筆者は JAPAN AI 株式会社および株式会社ジーニーに所属しますが、本稿は Alpha Beyond Frontier における筆者個人の独立した分析であり、所属各社の公式見解を示すものではありません。本稿は特定の企業の優劣を論じるものではありません。

    記載した数値および事実は、各出典の公表時点のものです。

    References

    本ブログの関連記事

  • AIの価値は、売った後に作られる——FDEは高粗利企業を作るのか、SI企業を作るのか

    AIの価値は、売った後に作られる——FDEは高粗利企業を作るのか、SI企業を作るのか

    AIの価値は、売った後に作られる

    はじめに:AIは、売って終わりではない

    これまでのソフトウェア・ビジネスは、ある程度完成したプロダクトを売り、導入を支援し、カスタマーサクセスが利用拡大を促す、という順序で回っていた。プロダクトは契約の時点でほぼ出来上がっており、あとは「どれだけ広く使ってもらうか」の勝負だった。

    Enterprise AI では、この順序が崩れる。顧客ごとにデータの持ち方、権限設計、業務フロー、例外処理、リスク許容度がまったく違う。生成AIは汎用的な能力を持つが、その能力が特定企業の現場で成果に変わるかどうかは、契約の時点ではまだ決まっていない。つまり、価値は売った時点では完成しておらず、導入したあとに、現場で作られる。

    これまでの記事では、生成AI企業の価値はモデルそのものではなく、非公開データ・業務フロー・実装力といった「業務への埋め込み」に宿ること、そしてその価値は ARR の大きさではなく「剥がれにくさ」として読むべきことを論じた。便宜的に、その剥がれにくい収益を Embedded ARR と呼んだ。本稿で考えたいのは、その剥がれにくい収益を、誰が、どの組織能力によって作るのか、である。

    近年その答えとして注目されているのが、Forward Deployed Engineer(FDE、フォワード・デプロイド・エンジニア) という職能である。FDEとは、ひとことで言えば、顧客の現場に入り込み、業務の理解・データの接続・実装・そしてプロダクトへの還流までを担うエンジニア職能のことだ。ただし先に結論を言えば、本稿は「FDEを持てば勝てる」という話をしない。FDEは諸刃であり、うまく設計できた会社だけが、それを剥がれにくい収益へと変えられる。

    1. なぜ、SaaSの組織モデルでは足りないのか

    伝統的なSaaS企業の組織は、おおむね機能ごとに分かれている。プロダクトを作るチーム、売るチーム(営業)、導入後の定着を担うチーム(カスタマーサクセス)、そして基盤を支えるエンジニアリング。それぞれが役割を持ち、顧客はこの分業のあいだを、バトンを渡されるように進んでいく。

    この構造は、完成したプロダクトを繰り返し届けるには効率的だ。だが Enterprise AI では、顧客課題の探索、データの接続、プロンプトやエージェントの設計、業務そのものの再設計、セキュリティ、運用への定着——これらが分離しにくい。どこまでが「プロダクト」で、どこからが「導入作業」なのかの境界が曖昧になる。エージェントを本番業務に乗せるには、その顧客の業務を深く理解した人間が、現場でデータとワークフローに手を入れる必要があるからだ。

    ここで、「プロダクトを作る人」と「顧客に届ける人」を分ける前提そのものが崩れはじめる。作りながら届け、届けながら作る。この境界の溶解こそが、FDEという職能が生まれた背景である。

    なお、これは「分業を全廃すべきだ」という話ではない。組織論の主流は、いまも分業を残したまま部門間の連携を設計し直す方向にある。ここで言いたいのは、AIの実装局面では、作る側と届ける側が同じ場所に立たざるをえない場面が増える、という傾向である。

    2. FDEとは何か——導入支援ではなく、価値を発見する職能

    FDEという職能を最初に確立したのは、Palantir だとされる。同社は社内でこの役割を “Delta” と呼び、エンジニアを顧客の現場に埋め込んで、自社プラットフォーム上で最も難しい課題を解かせてきた。Palantir 自身の説明が、この職能の本質を端的に表している。伝統的なソフトウェアエンジニアが「一つの機能を、多数の顧客に」届けるのに対し、FDEは「一人の顧客に、多数の機能を」作り込む。

    だから、FDEは受託開発ではないし、カスタマーサクセスやプリセールスとも違う。よく引かれる対比を借りれば、コンサルタントは契約の下流で、決められた要件に応える。FDEはロードマップの上流に立ち、顧客の現場で何が本当に必要なのかを発見し、それを実装し、使われ方を観察して、その学びをコア・プロダクトに戻す。この「製品への還流」があるかどうかが、単なる高級な実装請負とFDEを分ける決定的な違いだとされる。

    そしていま起きているのは、この職能が Palantir という一社の特殊解ではなくなりつつある、という現象だ。2026年に入り、大手プラットフォーマーが相次いでこのモデルを採り始めた。AWSは10億ドル規模の専任組織として、OpenAIは別会社として、Databricksは新組織として、AnthropicやGoogle Cloudは職種採用として——濃淡は異なるものの、各社が実装機能をソフトウェア・ビジネスの中心に据え始めている。各社が互いをどこまで意識したのかを公表資料から因果として読み取ることはできないが、実装を収益の中心に据え直す動きが同時多発的に起きていること自体は、確かな事実である。

    なぜ、これほどの資本と人材が「売ったあと」に注がれるのか。それは、そこにこそ収益の質を決めるものがあるからだ。独立系のリサーチノート Second Order Labs は、この点を挑発的にこう言い表している——AI契約からフォワード・デプロイド・エンジニアを引き剥がすと、その ARR は緩やかに縮むのではなく、蒸発する、と。やや誇張を含んだ比喩ではあるが、この一文は本質を突いている。裏を返せば、FDEこそが、剥がれにくい収益を作っている、ということだ。

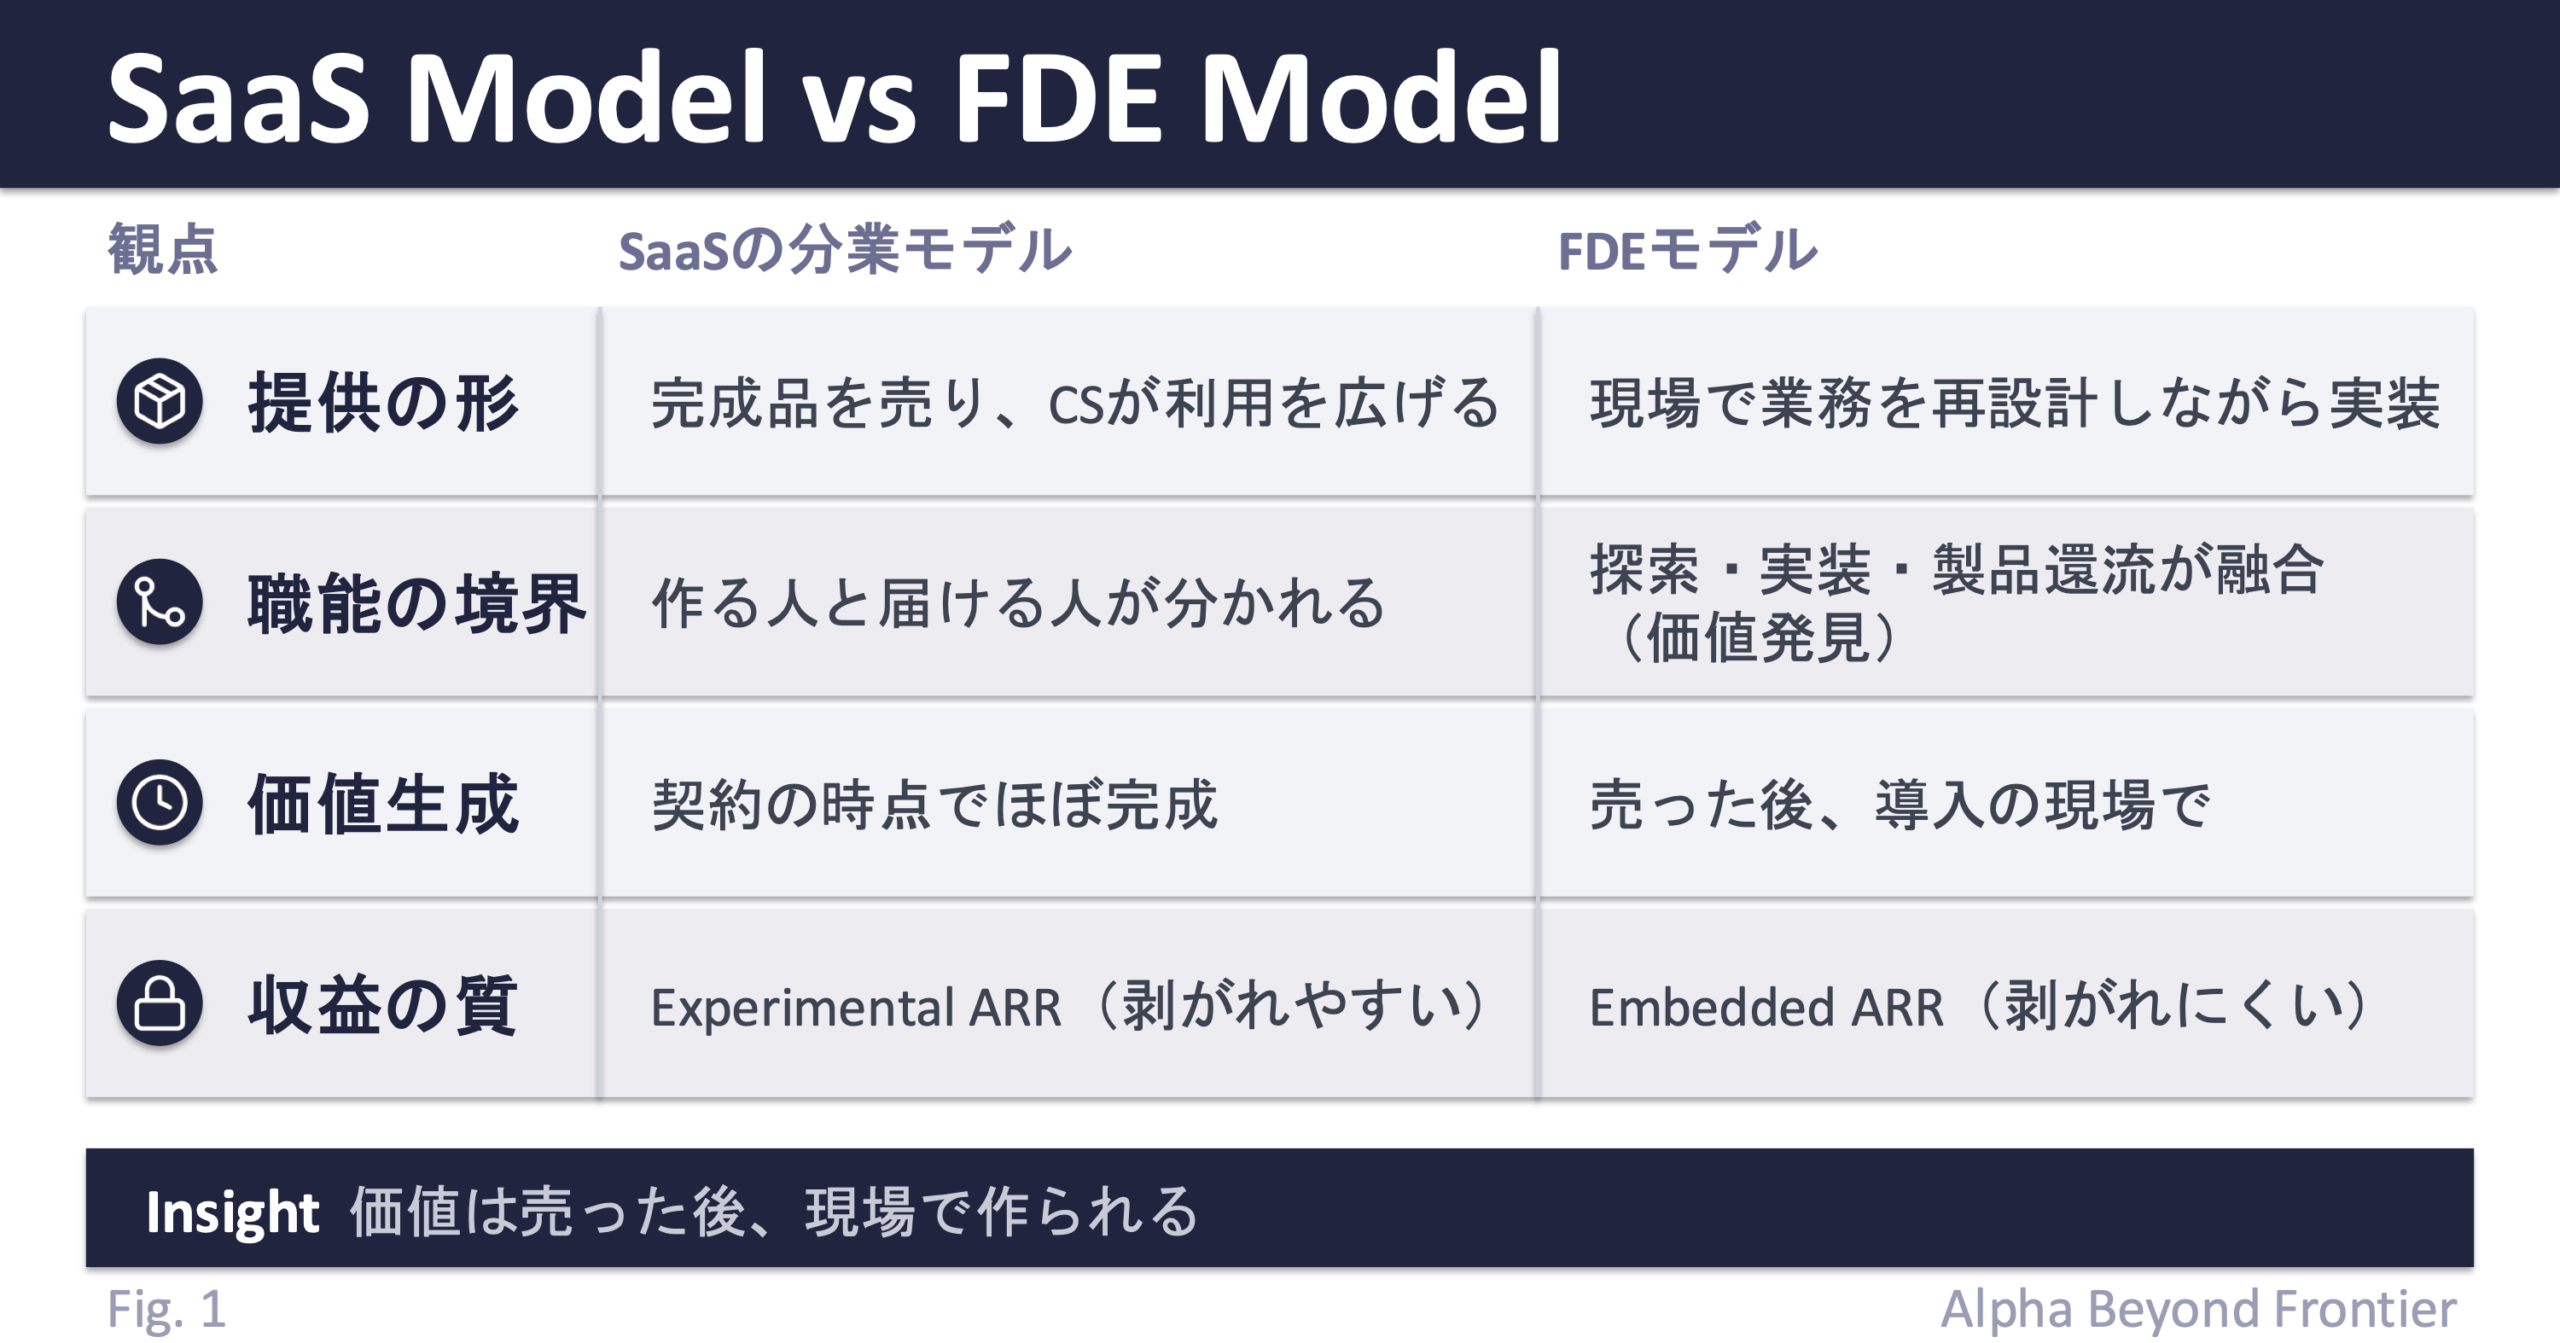
    図1: SaaSの分業モデルとFDEモデルの比較。提供の形の観点では、SaaSは完成品を売りカスタマーサクセスが利用を広げるのに対し、FDEは現場で業務を再設計しながら実装する。職能の境界の観点では、SaaSは作る人と届ける人が分かれるのに対し、FDEは探索・実装・製品への還流が融合する(価値発見)。価値が生まれる時点の観点では、SaaSは契約の時点でほぼ完成しているのに対し、FDEは売った後、導入の現場で価値が作られる。収益の質の観点では、SaaSは剥がれやすいExperimental ARRになりやすいのに対し、FDEは剥がれにくいEmbedded ARRを作る。価値は売った後、現場で作られる。

    3. FDEが作るもの——Experimental ARR を Embedded ARR に変える

    前稿で、AI企業の ARR には、実験的で剥がれやすい収益(Experimental)と、業務に埋め込まれて残る収益(Embedded)が混じり始めた、と書いた。FDEがやっているのは、まさにこの前者を後者に変える作業である。三つの側面から見ると分かりやすい。

    第一に、持続性。FDEは、一度きりの実証実験(PoC)の予算でしかなかった支出を、毎年の運用予算へと移す。話題で導入されただけのツールは半年で消えるが、現場の業務に組み込まれたものは、翌年の予算にあらかじめ織り込まれる。

    第二に、拡張。最初は一部署・一用途で始まった導入を、FDEは隣の部署、別のワークフローへと広げる。顧客の中で利用が面的に広がれば、その収益は簡単には剥がれない。

    第三に、モデル代替への耐性。基盤モデルが乗り換えられ、推論コストが下がっても、顧客の業務データ・運用ノウハウ・意思決定フローとの接点が手元に残れば、収益は残る。前稿で「価値はモデルではなく業務への埋め込みに宿る」と書いたが、その埋め込みを実際に手で作っているのがFDEだ、と言い換えてもいい。

    興味深いのは、この見方が、実装現場の観察からも裏づけられていることだ。SaaSの成長分析で知られる Kyle Poyar(Growth Unhinged)と ChartMogul が約3,500社の解約データを分析した調査は、安く簡単に買えるAI(月額数十ドル)ほど1年で大半の収益が失われる一方、月額数百ドル以上の関係はSaaS並みに残る、と示していた。そのうえで Poyar は、AIが原理的にできることと、顧客が現場で実際に得られる成果とのあいだのギャップを、実装の伴走によって埋めることが、解約への有効な備えになる、と論じている。そして、その伴走の担い手として名指しされるのが、FDEである。

    4. ただし、FDEには三つの罠がある

    ここまでを読むと、FDEは万能薬のように見えるかもしれない。だが実際には、同じ職能が企業を逆方向へ——スケールしない低粗利のビジネスへ——引きずり込む力も持っている。本稿がFDEを礼賛しない理由は、ここにある。罠は主に三つある。

    罠①:受託化リスク。 顧客ごとに個別対応を重ねすぎると、その会社はソフトウェア企業ではなく、実質的にシステムインテグレーター(SI)や受託開発の会社になる。前節で引いた「ARRが蒸発する」という指摘には、続きがある。もし収益の大半が、サブスクリプションの形をした個別実装の労働で成り立っているなら、それは「サブスクに見えるコンサルティング」ではないか、という問いだ。診断は意外に単純で、成長するにつれて実装労働のコストが収益に占める比率が上がっていくなら、その会社はソフトウェアではなくコンサルティングをスケールさせている。

    罠②:粗利率リスク。 高単価のエンジニアを顧客に張り付ければ、当然コストは重くなる。実際、AI企業の粗利率は推論コストの影響もあって50〜60%程度にとどまり、従来のSaaSの60〜80%超という水準には届かない、という指摘は根強い(この推論コストの話は前稿でも触れた)。FDEの人件費は、その上にさらに乗る。

    だが——ここが本稿の核心だが——この罠②は、無条件には成り立たない。FDEモデルの原型である Palantir は、FDEを大量に抱えながら、粗利率80%超を維持し、直近の四半期では調整後の営業利益率が6割に達し、市場からは極めて高い評価倍率を与えられている。実装比率が高い会社が、必ずしも低粗利・低評価に沈むわけではないのだ。

    罠③:プロダクト化失敗リスク。 そして、この罠②を分ける鍵が、罠③にある。現場で得た知見が、テンプレートや共通モジュール、業界別のパターンとしてプロダクトに戻らなければ、会社はスケールしない。調査会社の Constellation Research は、FDEが「不完全なツールや不安定なプラットフォームを覆い隠す“人間のミドルウェア”」になりかねないと警告し、それが単なる高級な統合作業に留まれば、いずれ役割そのものが失敗する、と指摘している。a16z も、FDEを独立したサービス部門に切り離すと、現場の学びが製品に還流しなくなり、会社は純粋なサービス業へ漂流する、と注意を促す。ここから、一つの診断基準が導ける——プロダクトの成熟と、人手による関与のギャップが時間とともに広がっていなければ、その会社は事実上サービス企業になっている、ということだ。

    つまり三つの罠は独立していない。プロダクト化に失敗すれば(罠③)、粗利は下がり続け(罠②)、会社は受託業へ漂流する(罠①)。逆に、実装の知見をプロダクトに戻し続けられれば、Palantir のように、実装企業でありながら高い粗利を保つこともできる。

    なお、念のため付言しておくと、「AIエージェントが実装を自動化すれば、そもそもFDEのような人間は要らなくなる」という見方もある。だが現時点では、FDE職の求人はむしろ急増しており、実装できる人材こそが普及の律速要因になっている、という逆向きの観察のほうが優勢だ。実装の自動化が進む余地は認めつつも、「だから不要になる」と断じるのは、いまのところ早い。

    5. 分かれ目は、FDEを学習ループに変えられるか

    では、高粗利の実装企業と、低粗利のSI企業を分けるものは何か。それは、FDEを持っているかどうかではない。持ったFDEを、個別実装を再利用可能な資産に戻し続ける学習ループに組み込めているかどうか、である。ここで言う高粗利の実装企業とは、実装を人手で積み上げる会社ではない。実装を通じて、次の顧客では人手を減らせる会社のことだ。

    この学習ループは、抽象論ではない。FDEモデルの普及を分析した a16z は、成功している組織にはいくつかの明確な制約が課されている、と観察している。たとえば、導入を無限に続けず、「90日で本番に乗せる」といった期限を切ること。四半期ごとに、その場限りで書いたコードを、再利用できる設定やテンプレートに畳み直すことを目標に据えること。そして、個々の実装を、小さく再利用可能な部品(データモデル、権限設計、ワークフロー・エンジンといった基本要素)の組み合わせとして作ること。Palantir が自らのモデルを「砂利道を舗装路に変えていく作業」と表現したのも、同じ発想だ。最初の顧客では手作業だったものが、次の顧客ではプロダクトの機能になり、その次ではもっと速くなる。実際、同社が上場時に開示した資料でも、経験を重ねるほど一つの顧客を立ち上げるのに必要なエンジニアの手間が減っていったことが示されている——実装がプロダクトに吸収されていく過程の、財務上の痕跡である。

    管理指標も変わる。個別案件の粗利だけを見ていると、この学習ループは回らない。見るべきは、その実装から生まれた知見が、次の顧客でどれだけ再利用されたか——将来の再利用率のほうである。突き詰めれば、FDEを正しく設計した会社が売っているのは「人月」ではなく、「再現可能な業務パターン」だ。人を張り付けて売上を立てるのではなく、張り付けた人が持ち帰った学びを、次の売上の原価を下げる資産に変えている。

    この違いは、外からは見えにくい。同じ「FDEを100人抱える会社」でも、片方はプロダクトが実装のたびに強くなり、もう片方は実装のたびに保守しきれない個別対応が積み上がっていく。前者は時間とともに実装が軽くなり、後者は重くなる。数年後に、片方は高粗利のソフトウェア企業として、もう片方は低粗利の受託企業として評価される。分かれ目は、最初から組織の設計に埋め込まれている。

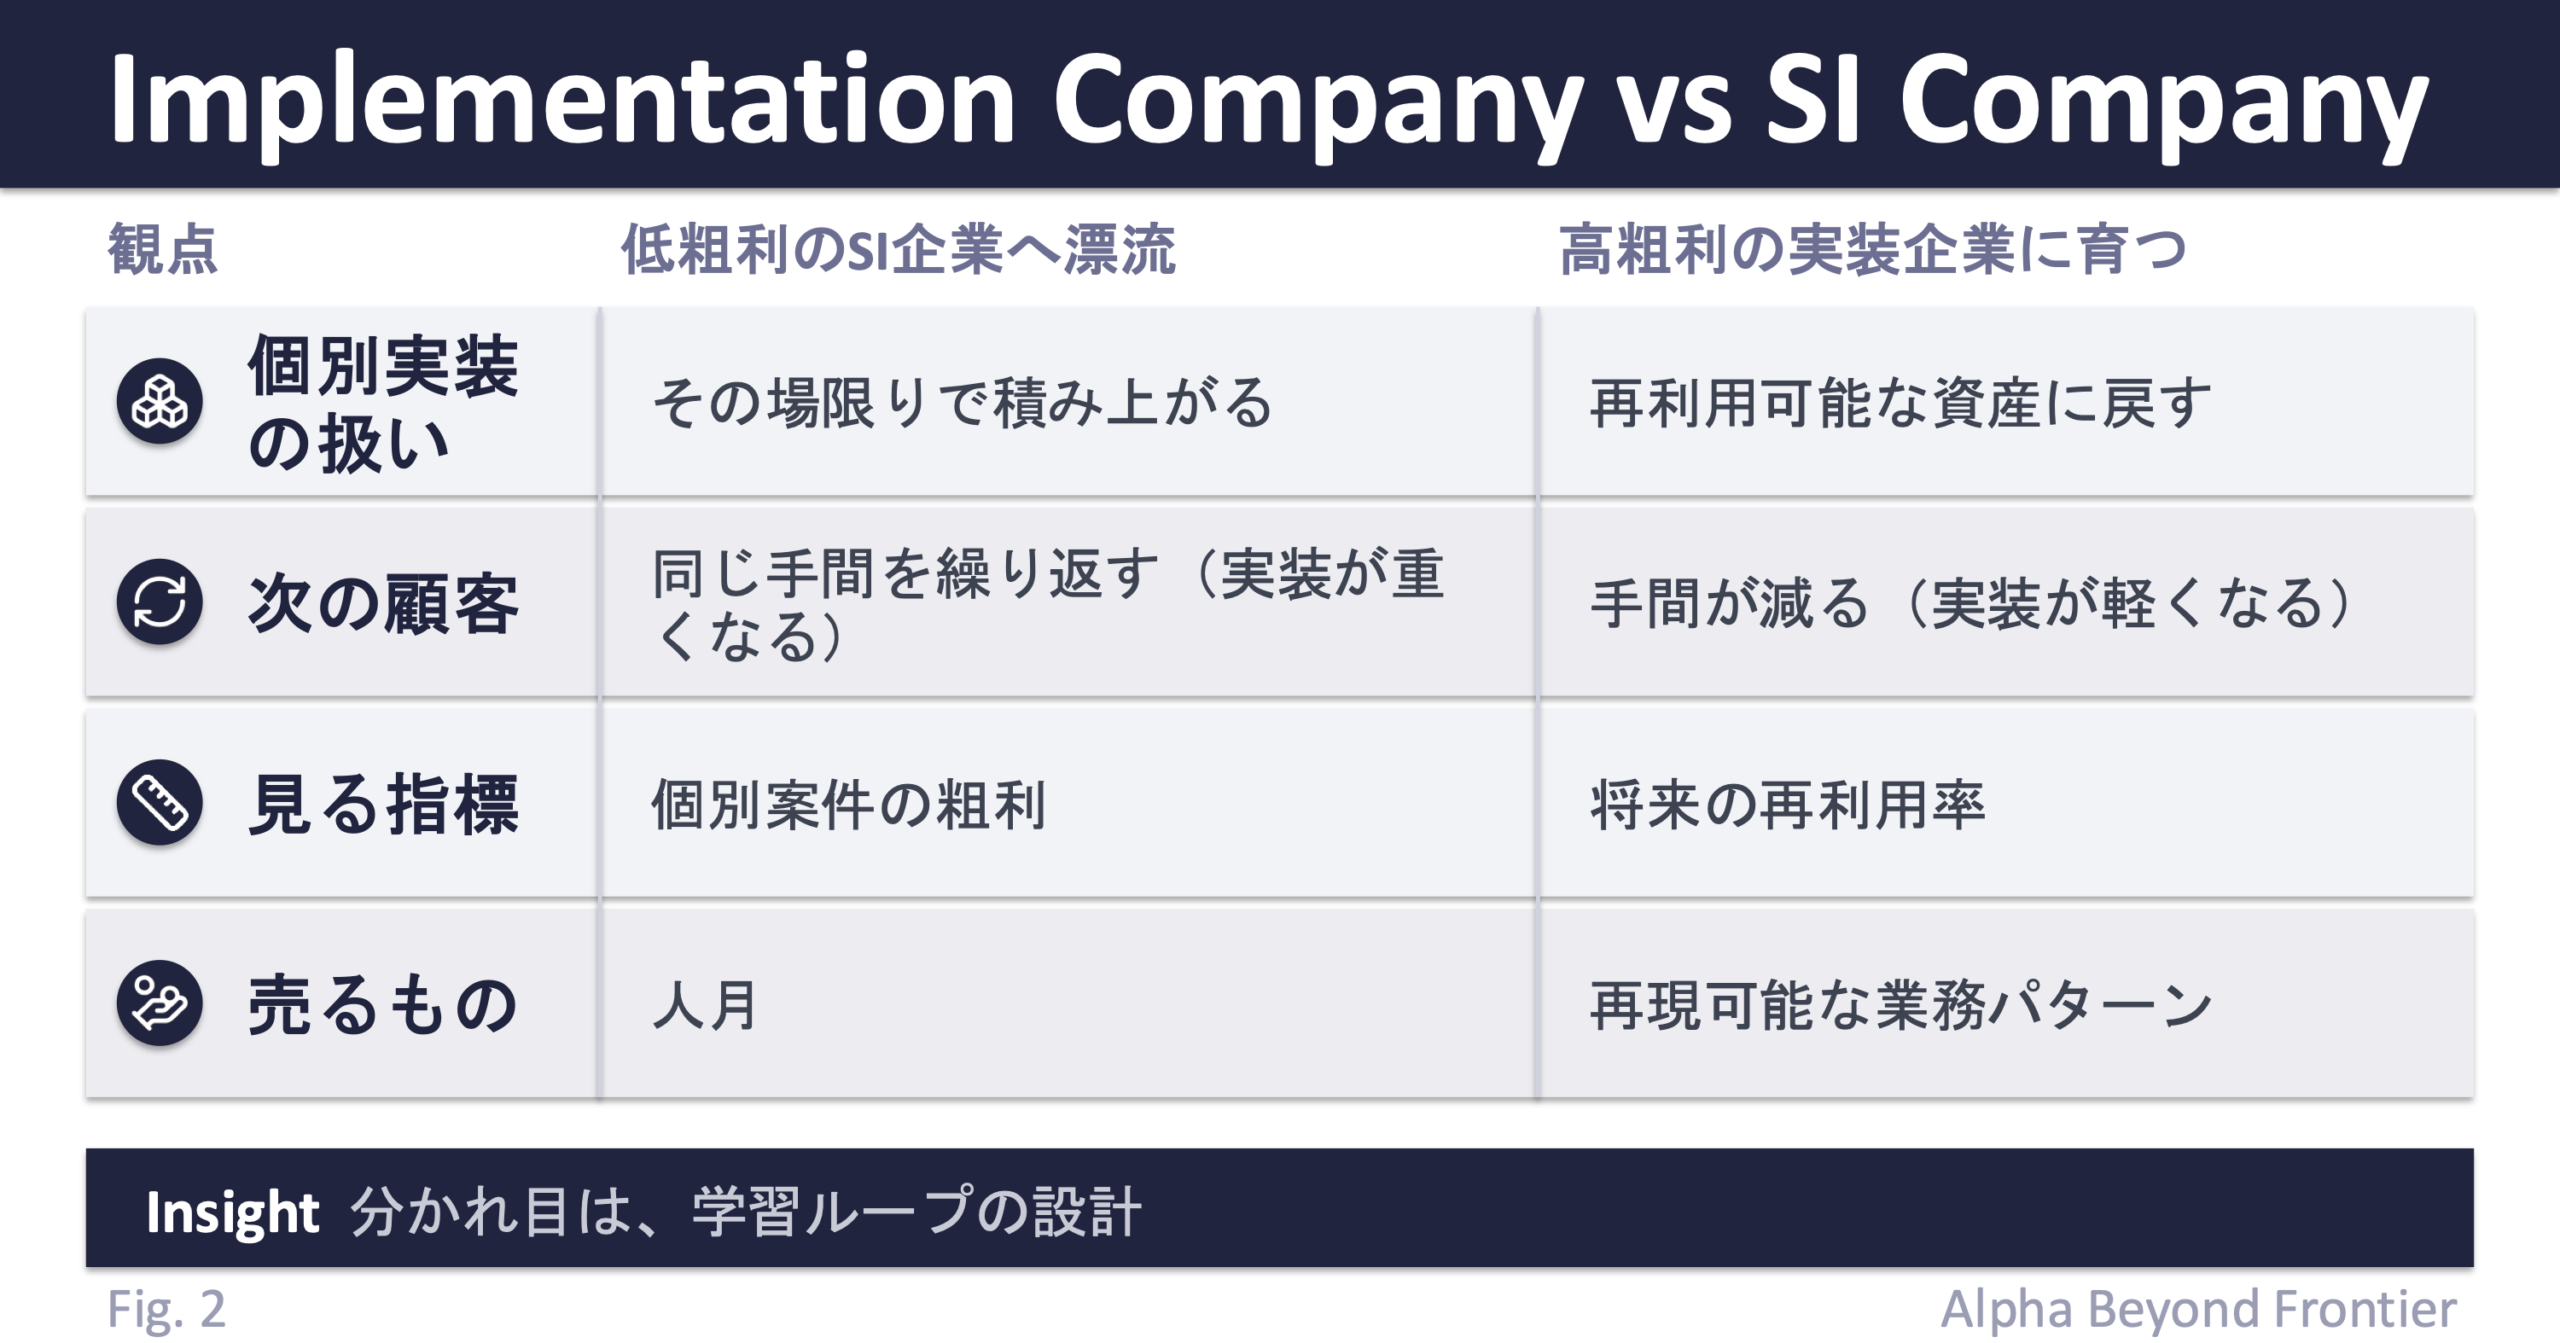
    図2: 同じFDEを持っていても、低粗利のSI企業へ漂流するか、高粗利の実装企業に育つかが分かれる。個別実装の扱いの観点では、その場限りで積み上がるSI企業に対し、実装企業は再利用可能な資産に戻す。次の顧客の観点では、SI企業は同じ手間を繰り返し実装が重くなるのに対し、実装企業は手間が減り実装が軽くなる。見る指標の観点では、SI企業は個別案件の粗利を見るのに対し、実装企業は将来の再利用率を見る。売るものの観点では、SI企業は人月を売るのに対し、実装企業は再現可能な業務パターンを売る。分かれ目は、FDEを学習ループに変えられるかどうかの設計にある。

    おわりに:AI企業は、SaaS企業か、実装企業か

    生成AIの時代に、企業の価値がどこに宿り(記事一本目)、それをどう測り(記事二本目)、そして誰がどう作るのか(本稿)——という三つの問いを、ここまでたどってきた。三つを貫くのは、価値がプロダクト単体から、実装・横展開・収益化を担う組織能力へと移りつつある、という一つの構造である。

    だからこそ、AI企業を「SaaS企業か、実装企業か」という古い二分法で捉えるのは、もう適切ではないのかもしれない。剥がれにくい収益を作れる会社は、実装企業の泥臭さと、ソフトウェア企業のスケール経済を、同じ組織の中で両立させている。その両立を可能にするのが、FDEを学習ループに変える設計であり、それができない会社は、実装の重さだけを抱えてSI業へと沈んでいく。

    FDEは、AI時代の魔法の杖ではない。だが、正しく設計できる会社にとっては、剥がれにくい収益を作るための、いまのところ最も現実的な組織能力である。「価値は売ったあとに作られる」という言葉は、裏を返せば、売ったあとに価値を作れる組織を持たない会社は、どれだけ優れたモデルを持っていても、その価値を自分の収益として留めておけない、ということでもある。

    この視点は、AIを売る側や投資する側だけのものではない。AIを買う側から見れば、問うべきことは「FDEがいるか」ではない。そのFDEが、自社向けの個別対応を積み上げるだけなのか、それとも自社の業務理解をプロダクトの改善に戻してくれるのか、である。導入支援の人数ではなく、導入後にそのプロダクトがどれだけ速く賢くなっていくかを見るべきだ。前者であれば、あなたは高い実装費を払い続ける顧客のままだが、後者であれば、あなたの業務知見がベンダーのプロダクトを鍛え、巡り巡って自社の運用も軽くなっていく。

    残る問いは、では、どの業務・どの業界でこの実装深度が最も効くのか、である。すべての領域でFDEが同じ重みを持つわけではないだろう。それは、次に考えたいテーマである。

    References

    なお本稿は、公開資料・各社の発表・VCや実務家の分析・関連報道をもとに、Enterprise AI 企業の組織能力について筆者なりの補助線を整理したものである。特定企業の非公開情報に基づくものではなく、すべて独立した一般的な構造分析である。財務数値や各社の動向は公表時点のものであり、その後の変動や前提の違いは反映していない。

    本ブログの関連記事

  • そのAIの売上は、本当に定着しているのか——AI企業の価値は『剥がれにくい収益』で決まる

    そのAIの売上は、本当に定着しているのか——AI企業の価値は『剥がれにくい収益』で決まる

    そのAIの売上は、本当に定着しているのか

    はじめに:AI企業の売上は、見た目ほど同じではない

    AI企業の評価額を見ると、しばしば「バブルではないか」と言われる。Databricks は2026年2月の調達で評価額が約1,340億ドルに達し、年率換算の売上は54億ドルを超えた。数字は壮観だが、AI企業全体については、こうした成長がどこまで持続的な収益なのかを疑う声も絶えない。

    だが、本当に問うべきは「評価額が高いか低いか」ではない。市場が何を価値として見ていて、何をまだ十分に測れていないかである。AI投資をめぐる議論も、最近は単純な強気・弱気の二択から離れつつある。ゴールドマン・サックスは「まだバブルではない」としつつ将来便益の過大評価を警告し、IMFは「局所的な過熱」という表現を使う。技術革命は本物だが、その上に乗る金融的な評価には歪みが混じりうる——この温度感がいまの相場観に近い。

    そして、この問いは投資家だけのものではない。AIツールを導入する企業、AIプロダクトを売る事業会社、AI機能を自社サービスに組み込む経営者にとっても、問いは同じである。あなたの会社が先月入れたAIツールは、本当に業務に定着しているのか。それとも、話題性で導入しただけで、半年後には解約されるものなのか。見るべきは「AIを使っているか」ではなく、そのAIが顧客や自社の業務にどれだけ深く組み込まれているか——言い換えれば、その売上がどれだけ剥がれにくいかである。

    そうであれば、論点は評価額そのものではなく、評価に使う物差しに移る。資本市場はAI企業を、どの言語で測っているのか。そして、その言語はAIにそのまま通用するのか。

    1. SaaSの物差しは、AIにそのまま効くのか

    ソフトウェア企業は長らく、共通の言語で評価されてきた。ARR(年間経常収益)、売上成長率、NRR、粗利率、Rule of 40、そしてそれらに基づく売上マルチプル(EV/ARR)。なかでもNRRは「売上継続率」とも呼ばれ、既存顧客からの売上が翌年にどれだけ残り、増えたかを見る指標である。100%を超えていれば、解約や縮小を上回って、既存顧客内で利用が広がっていることを意味する。投資家どうしが企業を比較するには、こうした共通の物差しが要る。

    AI企業も、現実にはこの言語で説明されている。市場はAI企業を別枠ではなく同じ物差しに乗せている。巨大なAIラボから、創業数年のアプリケーション企業まで、語られる言葉はARRであり、売上成長率であり、売上マルチプルだ。ベッセマーの Cloud 100(2025年)では、AI企業の平均売上マルチプルは約24倍で、非AI企業の約19倍を上回る。一見すると「AIプレミアム」が存在するように見える。

    しかしベッセマー自身が釘を刺している。プレミアムの源泉は「AIだから」ではなく、カテゴリ支配・予測可能な売上拡大・効率性であり、AIは成長の時間軸を圧縮するが、それ自体が堀(moat)を作るわけではない、と。実際、このマルチプル差はAIが当たり前になるにつれて縮みつつある。

    ここで違和感が浮かぶ。同じARRでも、中身が違うのではないか。単なるAPI利用料なのか、試験導入(PoC)の一時的な売上なのか、それとも顧客の業務に深く入り込んだ継続収益なのか。同じ「1億ドルのARR」でも、価値の質はまったく異なる。

    2. ARRが、もう一枚岩ではない

    この違和感を、最初に概念化したのは投資家側だった。アルティメーターのジャミン・ボールは、AI企業の収益の一部を ERR(Experimental Runrate Revenue=実験的ランレート収益) と呼び、従来のARRと区別した。AI時代には、ARRに見えるものの中に、実験予算・一時的な利用・ベンダー探索的な支出が混じる。それらは従来のARRほど予測可能でも安定的でもない、という問題提起である。a16z のジェニファー・リも「すべてのARRが同じ質ではない」と述べ、AI企業のARRを額面通りに読むことへの警戒は、すでに共通語彙になりつつある。

    安く入るAIは、安く抜ける

    データもこれを裏づける。Growth Unhinged と ChartMogul の2025年の分析(約3,500社をAIネイティブ/SaaSに分類)によれば、AIネイティブ企業のNRRの中央値は約48%で、B2B SaaSの約82%を大きく下回る。さらに重要なのは、その価格帯による二極化だ。月額50ドル未満の層では、解約・縮小の影響が大きく、NRRが約32%まで落ち込む。一方、月額250ドル超の層ではNRR約85%と、SaaS並みの水準に戻る。ある投資家は、調達資料に並んだ顧客ロゴに片端から連絡を取ったところ、その大半がすでに利用を止めていた、という逸話を紹介している。

    要するに、安く・簡単に買えるAIは、安く・簡単に解約される。月額数十ドルで気軽に試せるツールほど、話題が一巡すれば静かに解約される。逆に、月額数百ドル以上を払い続けてもらえる関係は、すでに業務の一部になっている。同じ「経常収益」に見えても、その粘りはまるで違う。

    つまり、AI時代に起きているのは「ARRが無意味になった」ことではない。ARRという同じ言葉の中に、実験的で剥がれやすい収益と、業務に埋め込まれて残る収益が混在し始めたことである。

    本稿が注目したいのは、ERRの裏側にある「残る収益」のほうだ。本稿ではこれを、便宜的に Embedded ARR、つまり「業務に埋め込まれた、剥がれにくい収益」と呼ぶ。問うべきはARRの大きさではなく、そのARRがどれだけ顧客の業務・データ・意思決定フローに埋め込まれているか、である。

    念のため付け加えておくと、Embedded ARR という言葉自体は、本稿での便宜的な呼び方にすぎない。重要なのは新しいKPIの名前を増やすことではなく、AI企業のARRを、実験的に積み上がったものと、業務に埋め込まれて残るものに分けて読むことである。スローガンにするなら、「ARRは死んだ」ではなく「ARRを分解せよ」だ。

    3. Embedded ARR をどう読むか:3つの差分

    では、ARRの「剥がれにくさ」は何で見分けるのか。本稿は3つの観点を置く。

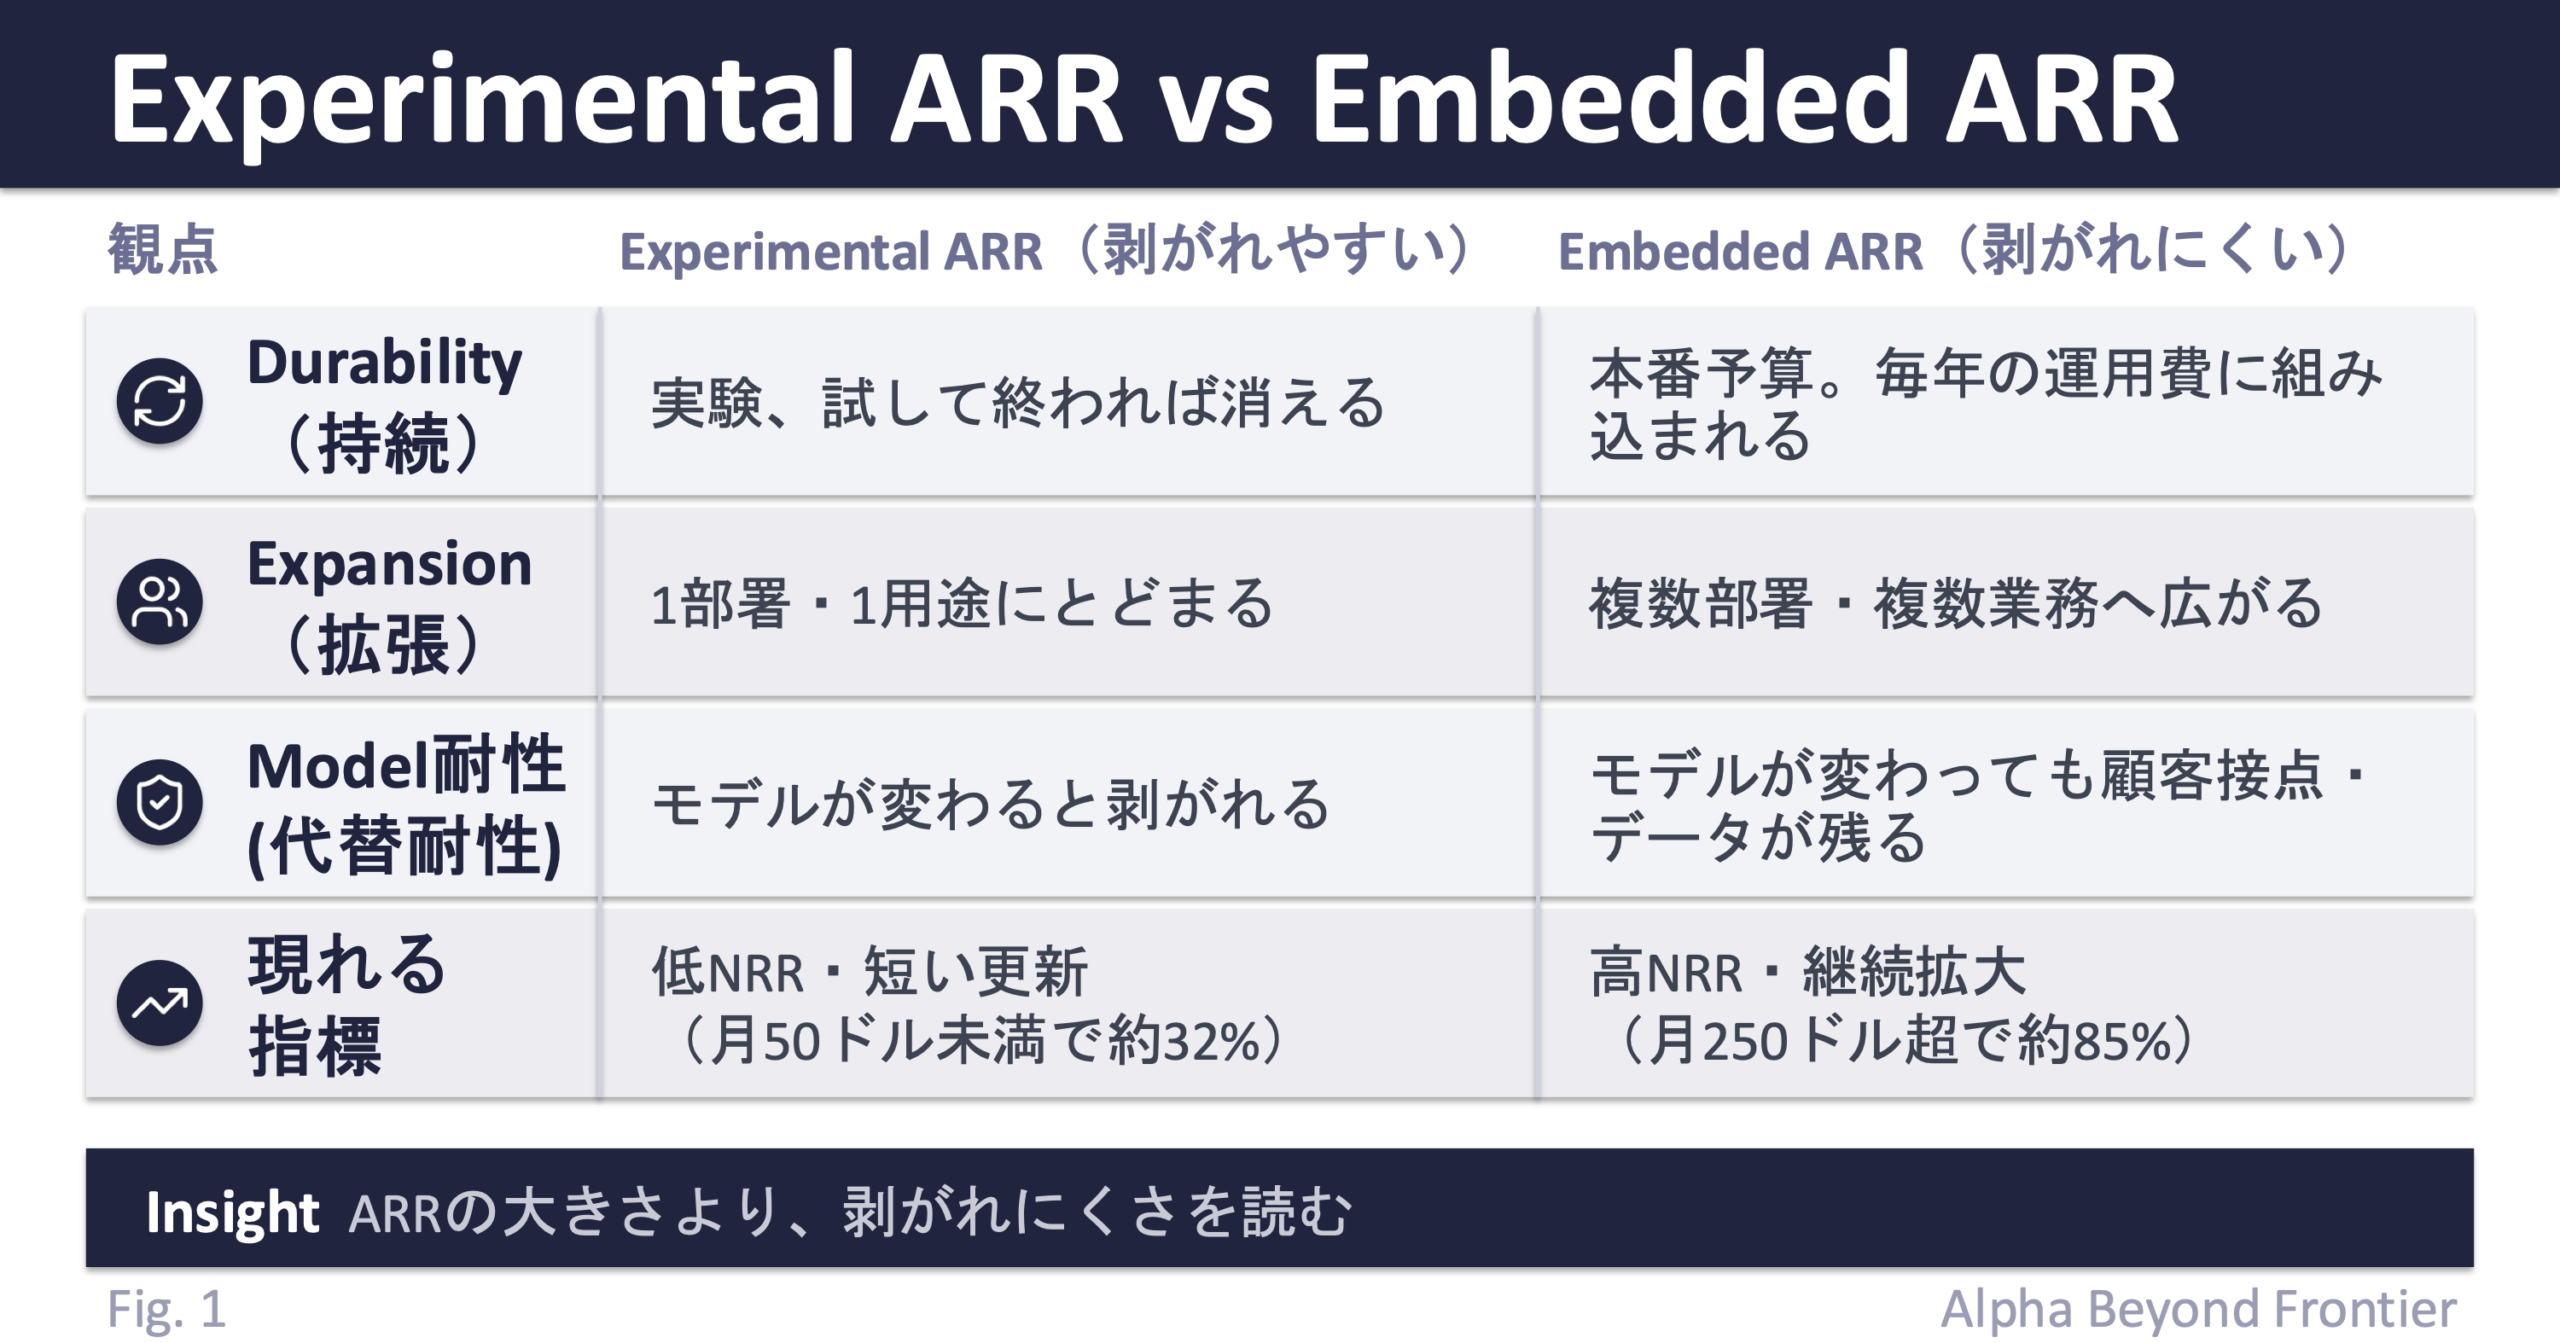
    第一に、Durability(持続)。契約が更新されるだけでなく、実験予算が本番予算に移っているか。一度きりのPoC枠から、毎年の運用コストとして組み込まれた支出へと性質が変わっているか。更新コホートやGRRに表れる。

    第二に、Expansion(拡張)。導入が1部署・1用途にとどまるのか、複数部署・複数ワークフローへ広がるのか。Databricks が2026年2月時点でNRR140%超、1,000万ドル以上を支払う顧客を70社超抱えると公表しているように、顧客内で利用が面的に広がる構造は、収益の剥がれにくさに直結する。

    第三に、Model-substitution resistance(モデル代替耐性)。基盤モデルが乗り換えられ、推論コストが下がっても、顧客接点・業務データ・運用ノウハウが手元に残るか。これは前稿で論じた「価値はモデルではなく、業務への埋め込みに宿る」という視点の、評価側への翻訳にあたる。モデルの差別化ではなく、モデルが変わっても残るものを評価する、という発想である。

    問題は、資本市場がこの3つを直接は観測できないことだ。だから市場は、代理変数を読む。NRRが高ければ、顧客内で利用が広がっている可能性がある。粗利率が改善していれば、推論原価を吸収できるプロダクト構造を持つ可能性がある。エンタープライズ比率や顧客ロゴの質が高ければ、ミッションクリティカルな領域に入り込んでいる可能性がある。逆にCapexや推論コストが重ければ、成長しても利益が残りにくい可能性がある。

    いずれも「可能性」であって、確定した観測ではない。代理変数は本体ではない。だが、ARRを一枚岩として見るより、これらの代理変数を通じて質を読み分けるほうが、AI企業の価値の所在にはるかに近づける。

    図1: Experimental ARR(剥がれやすい収益)と Embedded ARR(剥がれにくい収益)の対比。持続の観点では、実験予算で試して終われば消える収益に対し、本番予算として毎年の運用費に組み込まれる収益。拡張の観点では、1部署・1用途にとどまる利用に対し、複数部署・複数業務へ広がる利用。モデル代替耐性の観点では、モデルが変わると一緒に剥がれる収益に対し、モデルが変わっても顧客接点・データが残る収益。現れる指標としては、低NRR・短い更新(月50ドル未満で約32%)に対し、高NRR・継続拡大(月250ドル超で約85%)。ARRの大きさより、剥がれにくさを読む。

    4. 三つの層:価値の剥がれにくさは、どこで決まるか

    AI企業をひとくくりに語ると、この読み分けはかえって難しくなる。スタックの層によって、収益の質も評価のされ方も大きく異なるからだ。便宜的に三層に分けてみる。

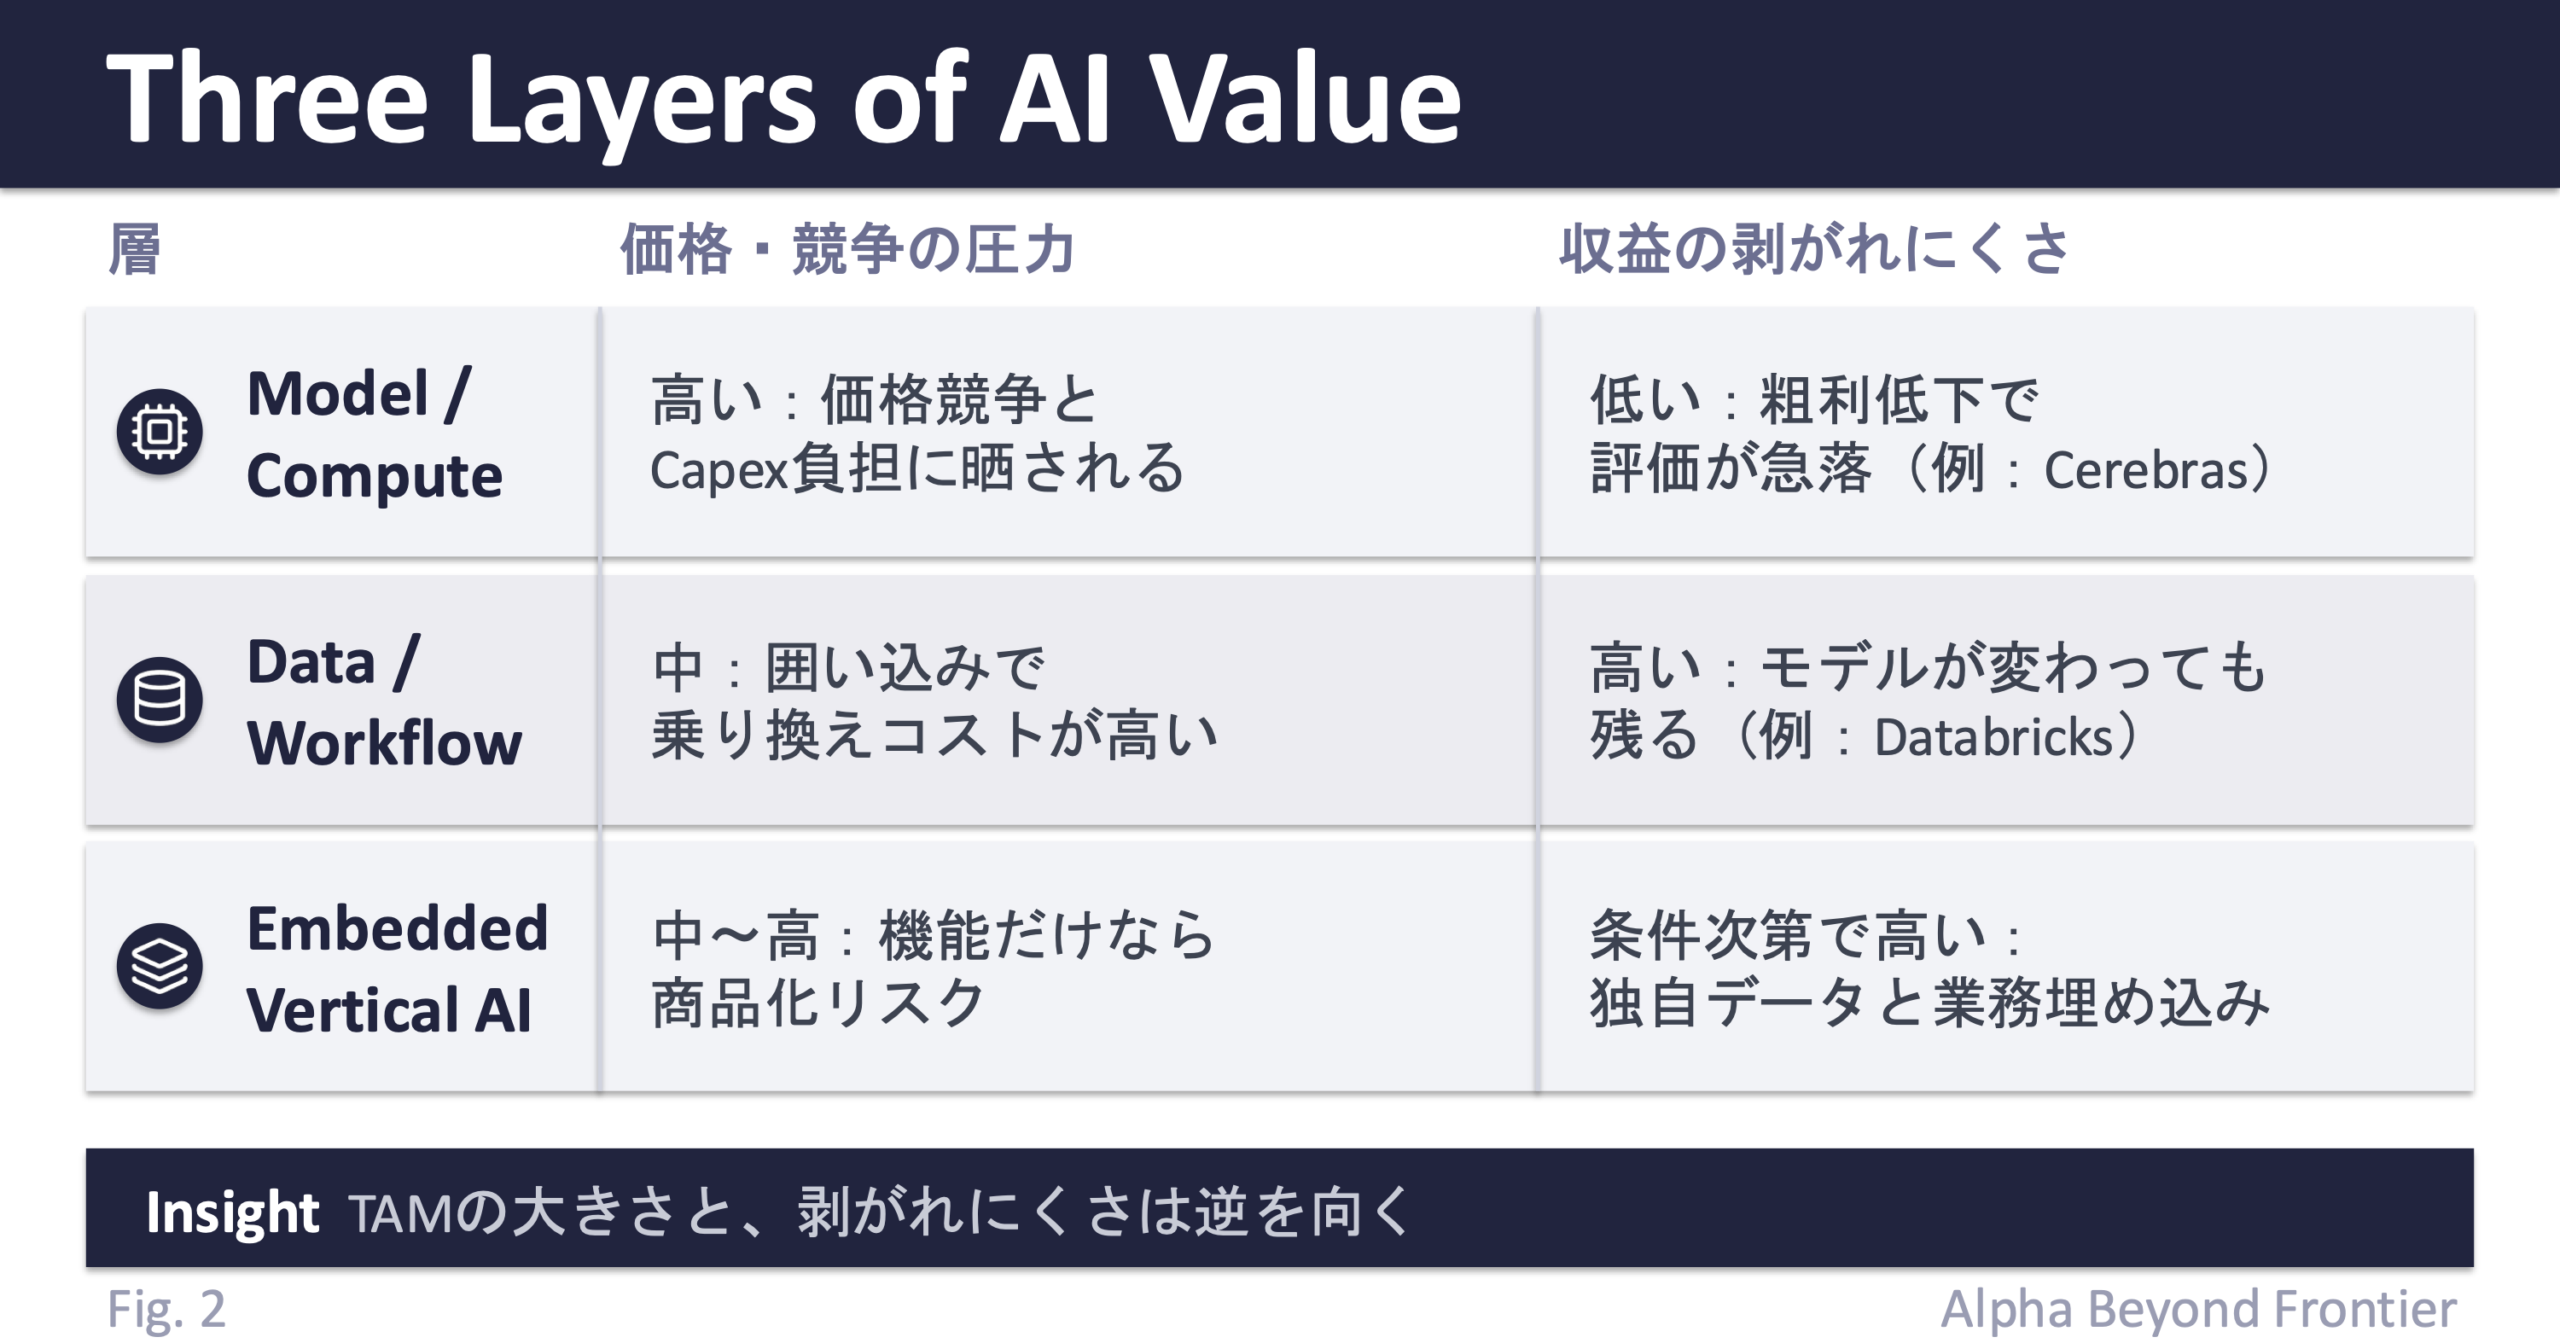
    Layer 1:Model / Compute(モデル・計算基盤)。モデルそのもの、GPU、推論基盤。売上ポテンシャルは巨大だが、価格競争とCapex負担に強く晒される。2026年5月に上場した Cerebras は、第1四半期に売上を前年比でほぼ倍増させながら、通期の調整後粗利率見通しが第1四半期の47%から38〜41%へ低下することを嫌気され、決算後に株価が時間外で約10%下落した。成長していても、粗利構造に不安があれば市場は容赦なく反応する。

    Layer 2:Data / Workflow Infrastructure(データ・業務基盤)。データ基盤や運用基盤の層は、モデルが入れ替わっても残りやすい。顧客のデータと業務がそこに蓄積され、乗り換えコストが高くなるからだ。Databricks の評価額1,340億ドルは、年率換算売上約54億ドルに対して、単純計算でおよそ25倍にあたる。同じデータ領域でも Snowflake の売上マルチプルはこれを大きく下回る水準とされる。両者の差をすべてAIだけで説明することはできないが、少なくとも市場が「AI時代のデータ・業務基盤」としての位置取りを大きく評価していることは読み取れる。

    Layer 3:Embedded Vertical AI(業務特化型AI)。一見すると市場規模が小さく見える層だが、特定業界の業務に深く入り込めば、解約耐性と横展開余地は大きい。たとえば、建設現場の見積・工程管理、医療機関の文書作成、製造業の品質管理、自治体の申請処理、法務部門の契約レビューのように、特定業務のデータ・承認フロー・例外処理に入り込むAIである。汎用チャットボットの一般利用とは、収益の粘りが違う。垂直特化型SaaSのうちNRRが115%を超える企業は、水平型に対して25〜30%の評価プレミアムを得るという集計もある。TAMが大きく見える層ほど価格競争に晒され、TAMが小さく見える層ほど、剥がれにくい収益を積みやすい場合がある——これは直感に反するが、収益の質という観点からは筋が通る。

    ただし、ここで言い切りは避けたい。第一に、Layer 1とLayer 2を一緒くたにはできない。GPU・電力・データセンターといった「つるはしとシャベル」は、むしろ商品化と価格競争のリスク側にある。第二に、「インフラ層なら安全」とも限らない。ゴールドマンの集計では、GPUや電力、データセンターなどのAIインフラ関連株の年初来上昇率が約44%に対し、2年先の利益予想の伸びは約9%にとどまる。設備投資の伸びが鈍れば、これらが一斉に評価を切り下げられる可能性は残る。光ファイバー(2000年)やクラウドの過剰供給が辿った道だ。第三に、Layer 3の優位も無条件ではない。差別化が同じ基盤モデル上の機能(feature)にすぎなければ一時的で、独自データに支えられて初めて持続する。実際、買い手の8割が「AIによる商品化」をソフトウェア評価の最大リスクに挙げるという調査もある。

    図2: AI企業の三つの層と、収益の剥がれにくさ。Model/Compute層(モデル・計算基盤)は価格競争とCapex負担に強く晒され、粗利低下で評価が急落しやすい(例:Cerebras)。Data/Workflow層(データ・業務基盤)は囲い込みで乗り換えコストが高く、モデルが変わっても残りやすい(例:Databricks)。Embedded Vertical AI層(業務特化型AI)は機能だけなら商品化リスクがあるが、独自データと業務への埋め込みがあれば条件次第で剥がれにくい。TAMの大きさと、剥がれにくさは逆を向くことがある。

    おわりに:ARRの大きさから、ARRの剥がれにくさへ

    AI企業の粗利率をめぐる議論も、この「読み分け」を後押しする。a16z が2020年に指摘した「AI企業の粗利はSaaSより薄い」という見立ては、当時はLLM普及前のものだったが、いまも部分的に当たっている。ICONIQの2026年の調査では、AIプロダクトの粗利率の中央値は約52%で、成熟SaaSの70〜80%には届かない。推論コストが重く、AIプロダクトの総コストの2割超を占めるとされるためだ。一方で、推論コストは年単位で大きく下がり続けており(いわゆるLLMflation)、粗利は改善の途上にある。つまり粗利率もまた、一枚岩のARRと同じく、層とプロダクト構造によって大きく割れる指標である。

    資本市場は、AI企業の価値をまだ直接は測れない。だからARR、成長率、粗利率、NRR、Capex負担といった、SaaS時代から続く代理指標で測っている。それ自体は誤りではない。誤りがあるとすれば、ARRを一枚岩として、その大きさだけを読むことだ。

    実務に引き寄せれば、AI企業やAIプロダクトを見るときに問うべきことは、意外にシンプルである。第一に、その売上は実験予算なのか、本番予算なのか。第二に、その利用は一部署に閉じているのか、複数業務に広がっているのか。第三に、明日、別のモデルに置き換わっても、顧客接点・業務データ・運用ノウハウは残るのか。この3つに答えられないARRは、見た目ほど強くない。これは自社のAI導入を点検するときにも、AIプロダクトを売る側が自分の収益を見るときにも、そのまま使える。

    AI時代、ARRは死んでいない。ただし、ARRはもう一枚岩ではない。実験的に積み上がったARRと、業務に埋め込まれて残るARRを分けて読めるかどうか——これは投資家だけの話ではなく、AIを買う側、売る側、組み込む側のすべてに関わる。市場はまだ古い物差しを使っている。だが、その物差しの読み方を変えれば、AI企業の本質はかなりの程度まで見えてくる。見るべきは「AIかどうか」ではなく、そのAIがどれだけ業務から剥がれにくいか。問われているのは新しい指標ではなく、既存の指標を質で分解して読む規律のほうである。

    References

    なお本稿は、公開資料・VCのレポート・各社の発表・関連報道をもとに、AI企業の価値評価について筆者なりの補助線を整理したものである。特定企業の非公開情報に基づくものではなく、すべて独立した一般的な構造分析である。評価額や財務数値は公表時点のものであり、その後の変動や前提の違いは反映していない。

    本ブログの関連記事

  • 生成AIはモデル単体では差別化にならない——AI企業の本当の堀はどこにあるのか

    生成AIはモデル単体では差別化にならない——AI企業の本当の堀はどこにあるのか

    生成AIはモデル単体では差別化にならない

    はじめに:モデルが横並びになる世界で、価値はどこに残るのか

    新しいAIプロダクトを立ち上げるとき、最初に悩むのは「どのモデルを使うか」かもしれない。GPT系か、Claude系か、それともオープンモデルを自前で動かすか——。だが、この選択の重みは、ここ1〜2年で急速に小さくなっている。少なくとも、モデル単体の性能差だけで長く差別化することは難しくなってきた。

    実際、基盤モデルの性能差は急速に縮まり、推論のコストは大きく下がり、オープンウェイト(モデルの重みが公開され、自前で動かせる)のモデルも商用利用に耐える水準へ達してきた。Stanford HAI の AI Index 2025 や研究機関 Epoch AI の分析も、上位モデル間の性能差の縮小と、同じ仕事をさせるコストの継続的な低下を裏づけている。要するに、どのモデルを選ぶか自体が、もはや差別化になりにくくなっているのだ。

    だとすれば、問いはこう変わる。モデルそのものが横並びに近づく世界で、生成AI企業の価値はどこに残るのか。そして——本稿がより重視するのはこちらだが——その価値のうち、投資家や買い手は何に値段をつけるのか(資本市場は何を「価値」として認識するのか)。

    先に見立てを述べておく。生成AI時代の企業価値は、モデルではなく、非公開データ・業務フロー・暗黙知・実装力に宿る。いずれも「業務に深く埋め込まれて、外に持ち出せないもの」である。そして資本がそれを価値として評価できるかどうかは、その埋め込みが「どれだけ深く、どれだけ再現困難か」にかかっている。

    1. モデルは「持ち出せる」、価値の源泉は「持ち出せない」

    モデルは、誰でも同じものを使える。APIを叩けば同じ出力が得られ、オープンモデルならダウンロードもできる。つまりモデルは原理的に「持ち出せる(portable)」資産であり、持ち出せるものはコピーされ、コモディティ化していく。著名アナリストの Benedict Evans も、基盤モデルは持続的な差別化を欠く「コモディティ的な入力」になりつつあり、価値は流通やワークフローへの統合、アプリケーション層へ移ると論じている。

    ここで一つ注意したい。これは「モデル層に価値が一切残らない」という意味ではない。a16z の Martin Casado らは2023年の時点で、生成AIのスタックそのものに自明な防御性はないとしつつ、スケール・流通・ブランドといった伝統的な堀で企業価値は築けると論じていた。論点は「モデルが無価値になる」ことではなく、「差別化の重心がモデルの外側へ移る」ことにある。

    では、その外側とは何か。本稿はそれを一つの概念で束ねたい——業務に埋め込まれて持ち出せない資産(embedded assets)である。非公開データ、業務フロー、暗黙知、実装力。これらは別々の要素に見えるが、共通点は「特定の顧客の業務のなかに深く埋め込まれていて、外から観察できず、移転に時間がかかる」という一点だ。モデルが portable なら、価値の源泉は embedded である。この対比が本稿の軸になる。

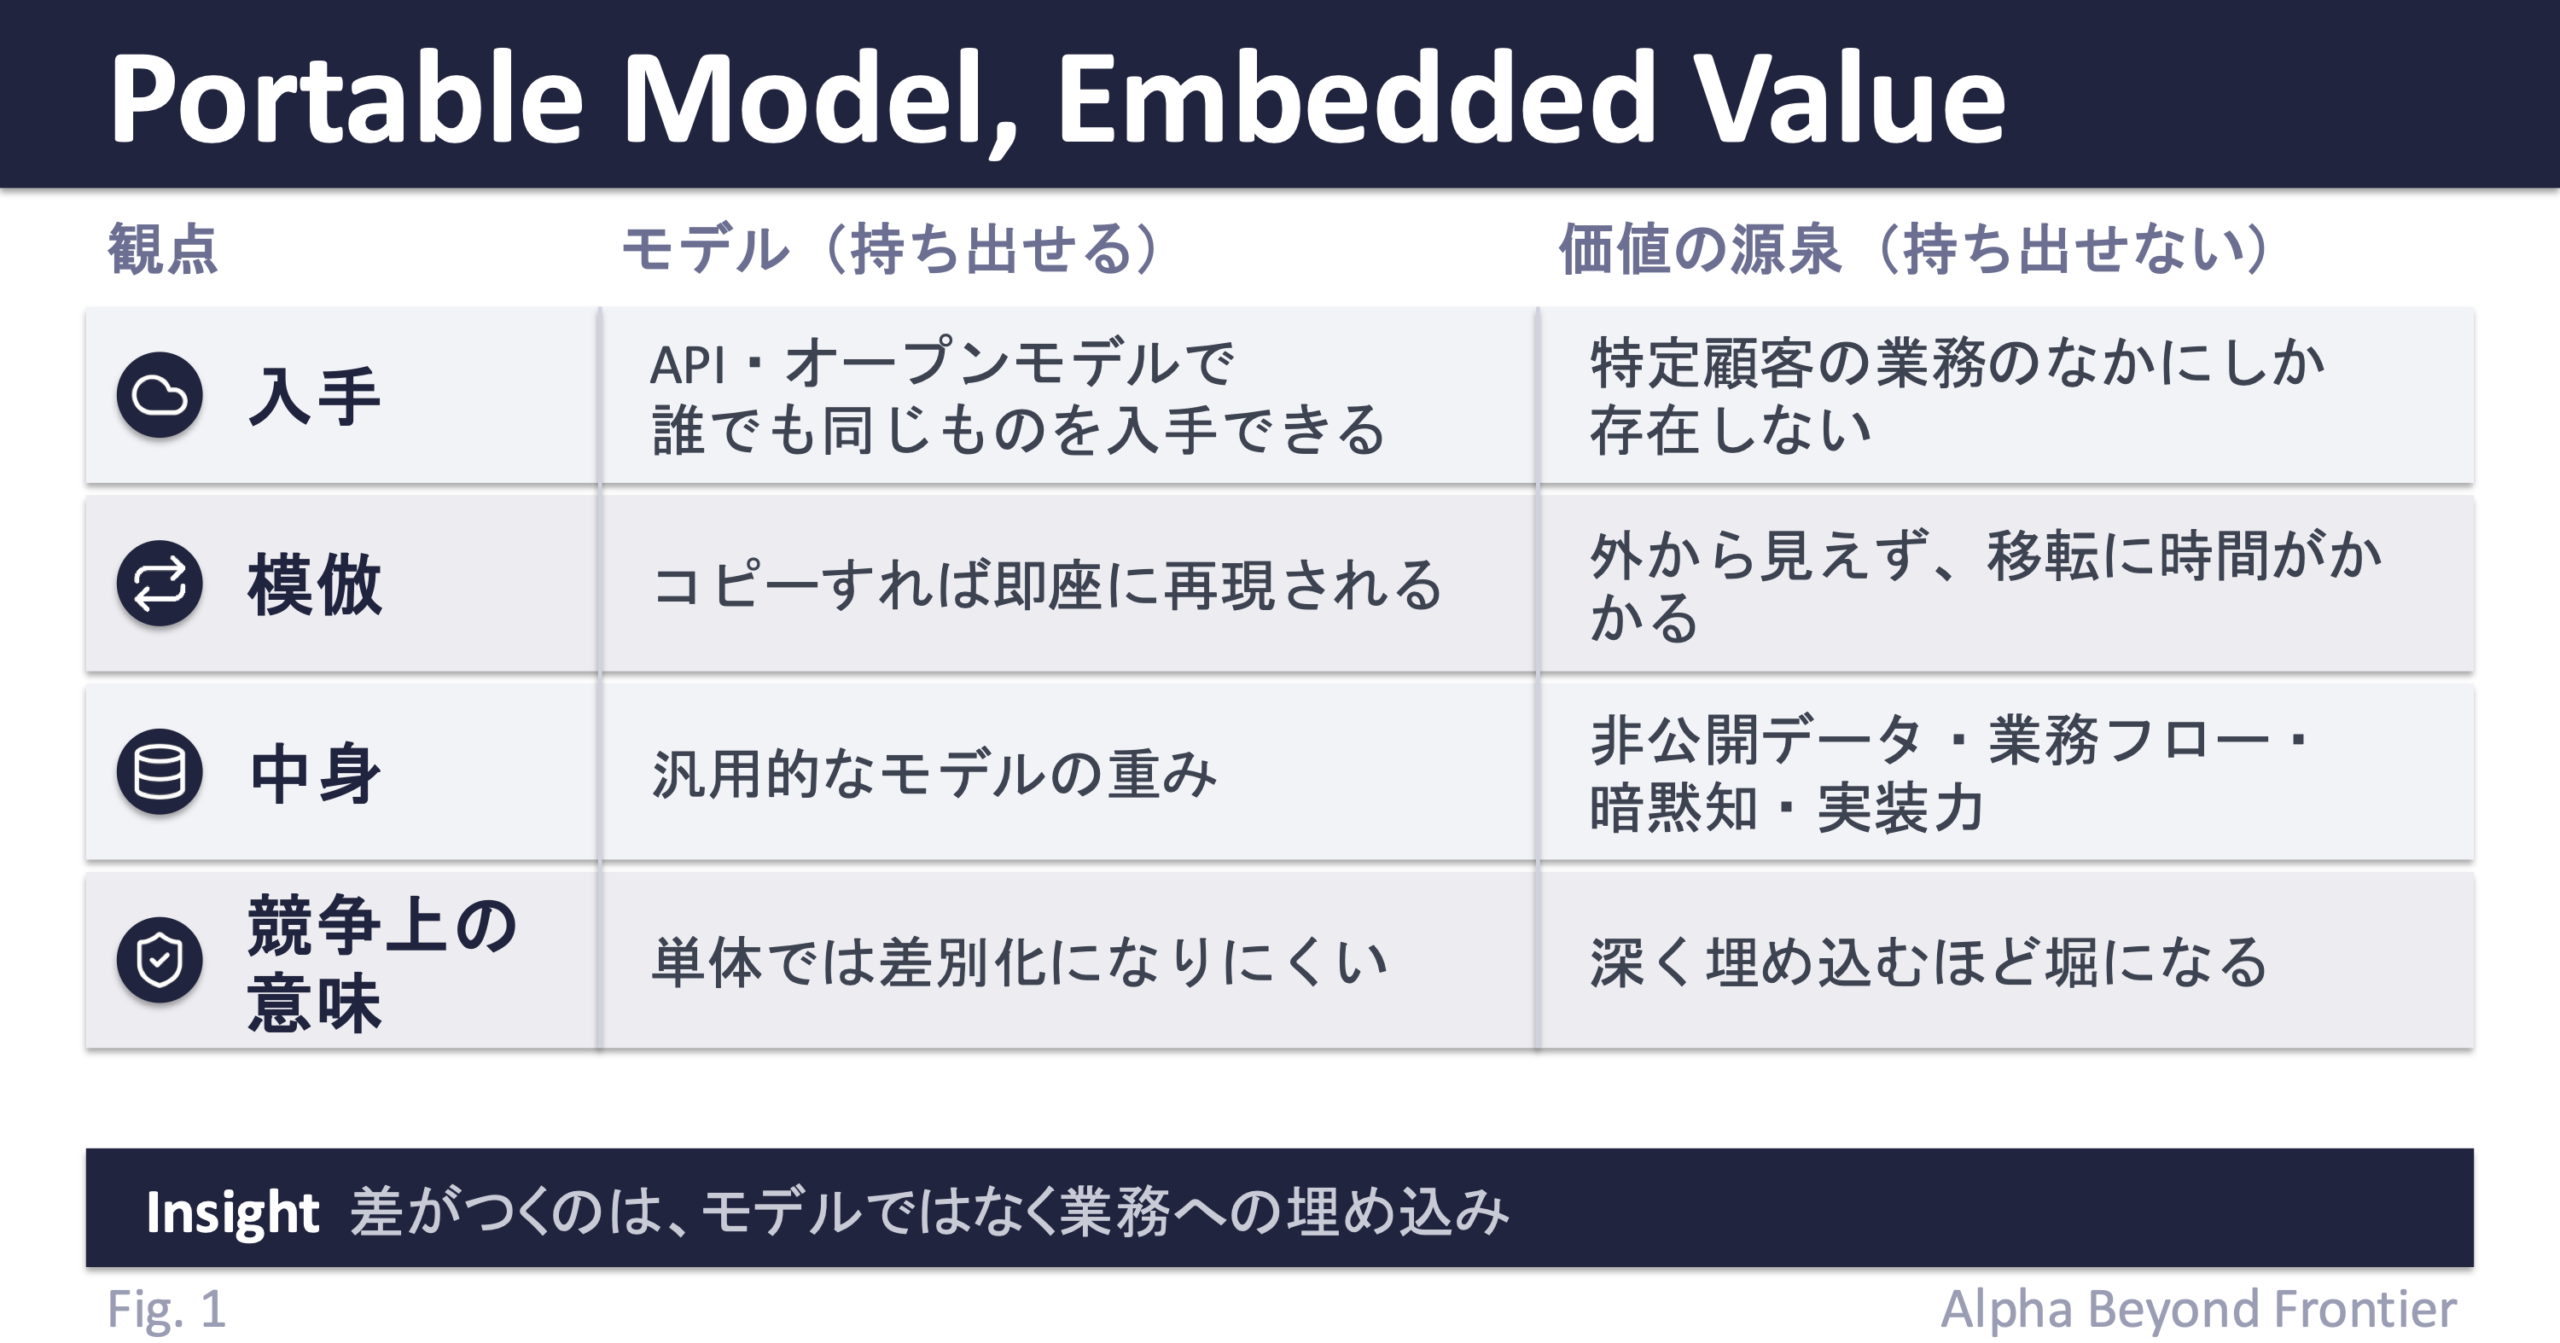
    図1: 持ち出せるモデル(portable)と、持ち出せない埋め込み資産(embedded)の対比。モデルはAPIやオープンモデルで誰でも同じものを入手でき、コピーすれば即座に再現され、単体では差別化になりにくい。一方で価値の源泉である非公開データ・業務フロー・暗黙知・実装力は、特定顧客の業務のなかにしか存在せず、外から見えず移転に時間がかかり、深く埋め込むほど堀になる。差がつくのは、モデルではなく業務への埋め込みである

    2. 埋め込み資産はどう積み上がるのか——データ・暗黙知・実装力

    埋め込み資産の中身を、もう少し具体的に見ていく。

    第一に、非公開データと暗黙知。ただし「独自データを持っていれば堀になる」という単純な話ではない。実際、公開された議論には両論がある。一方には「proprietary data こそが唯一持続する優位だ」という見方があり、他方には「基盤モデルは公開データで作られており、データ単独では複製もされ陳腐化もする」という反論がある。どちらも一理ある。重要なのは、データが業務フロー・評価基準・実装人材・顧客内での展開と結びついたときに、はじめて堀になるという点だ。生のデータそのものではなく、「誰がいつ何を正解と判断するか」という暗黙知を、業務の文脈のなかで構造化し、運用に乗せていく工程——そこに価値が宿る。この工程は外から見えず、時間がかかり、模倣が難しい。

    第二に、実装力。ここで近年あらためて注目されているのが、Forward Deployed Engineer(FDE、顧客の現場に深く入り込んで実装する技術者)という役割である。これはデータ解析企業 Palantir が確立・普及させた職種で、エンジニアが顧客の業務現場に深く入り込み、一社のために多くの機能を実装し、定着させる。Palantir 自身の説明でも、汎用プロダクトを多くの顧客へ届ける通常の開発者とは逆に、FDE は一顧客に張り付いて業務に食い込む役割だとされる。

    興味深いのは、生成AIの最前線がこのモデルに回帰していることだ。OpenAI は2026年5月、企業導入を専門に担う「Deployment Company」の設立を公表し(同社の発表によれば、数十億ドル規模の初期資本と、約150名の FDE・導入スペシャリストを擁するという)、Anthropic も Forward Deployed Engineer を公式に募集している。モデルがコモディティ化するほど、それを顧客の業務に「埋め込んで動かす」力が希少になる、という構図である。

    ここに一つの逆説がある。FDE的な実装は、一見すると「スケールしないサービス業」に見える。一社ごとに人を張り付けるのだから、ソフトウェアの高い限界利益とは相容れない。だが a16z が指摘するように、初期にマージンを犠牲にして業務へ深く埋め込むことが、結果として顧客が離れられない関係——強い堀——を生むことがある。スケールしないように見える作業こそが、最も模倣困難な資産になりうる。もっとも、これは現時点で実証された因果ではなく、サービス事業は低マージンでスケールしにくいという従来の反論も併存する、戦略的な仮説として扱うのが正確だろう。

    3. すべての Vertical AI が勝つわけではない

    埋め込み資産が価値を生むのなら、それを最も積み上げやすいのは、特定業界に特化した Vertical AI である。a16z、Bessemer、Menlo Ventures といった著名VCは近年、AI の価値が汎用モデルそのものではなく、特定業界のワークフロー・固有データ・規制要件への深い埋め込みへ移ると論じている。これは「Vertical SaaS は横断型より深い堀を持つ」という旧来の議論の、AI 時代への延長線上にある。

    ただし、ここで楽観に振れてはいけない。同じVCのなかからも、強い反対論が出ている。Foundation Capital や Theory Ventures は、基盤モデルの提供者が API の利用データから成功しているアプリを観測し、自らスタックを上がってアプリ層を飲み込んでくる「飲み込みリスク」を警告する。汎用的な知識労働をなぞるだけの薄いアプリは、モデル提供者の機能拡張に最も飲み込まれやすい。

    重要なのは、これらの論者が「Vertical AI は安全だ」とは言っていないことだ。彼らが描いているのは線引きである。すべての Vertical AI が勝つわけではない。勝ち筋があるのは、判断集約的で、顧客固有のデータが相互作用のなかで蓄積し、業務フローに深く埋め込まれる領域である。ここでいう判断集約的な業務とは、単に作業を自動化するだけでなく、例外処理、承認、責任分界、顧客ごとの判断基準が絡む業務である。逆に、定型的でルールベースの業務や、汎用的な知識をなぞるだけの領域では、固有の学習がほとんど蓄積されず、堀にならない。

    つまり Vertical AI の本質は、「業界を絞ること」自体ではない。「絞った業界のなかで、モデル提供者が再現できない埋め込み資産をどれだけ積めるか」にある。市場規模がどこまで広がるか、どの業界が最初に立ち上がるかは、上場実績の乏しい現時点では検証されていない仮説として扱うべきだが、構造としての勝ち筋の在りかは、かなりはっきりしている。

    4. 売上だけでは測れない——AI企業の価値をどう読むか

    ここからが本稿の芯である。埋め込み資産が価値の所在だとして、では資本市場はそれをどう評価するのか。

    従来のSaaSは、ARR(年間経常収益)とその成長率、そして顧客の定着を測る NRR(Net Revenue Retention=既存顧客から得る収益が前年比でどれだけ維持・拡大したか)を中心に評価されてきた。だが生成AI企業を同じ物差しで測ると、見誤る。

    整理すると、生成AI企業を見るときは、売上がどれだけ伸びているかだけでなく、その売上が剥がれにくいか(定着)、推論の原価を食いつぶさないか(粗利)、そして一社ごとの作り込みが再利用できる形になっているか(製品化)——この三つを合わせて見る必要がある。順に見ていこう。

    第一に、ARRの質、つまり売上が剥がれにくいかどうかが違う。Kyle Poyar の集計(2025年)によれば、ARR が25万ドルを超える企業で、従来型 B2B SaaS の NRR が中央値で80%台前半であるのに対し、AIネイティブ企業では、とくに低単価で実験的に使われている層の顧客の定着(リテンション)がそれを大きく下回る。逆に、単価が高く本格的な業務利用に根ざした層では、定着は従来SaaSに近い水準まで上がる。生成AIは導入が速い分、同じ「AIネイティブ」のなかでも、実験的な支出と本格的な業務利用が混在しやすいということだ。同じ「1億円のARR」でも、業務に深く埋め込まれた剥がれにくい収益なのか、試しに使われているだけの収益なのかで、中身がまるで違う。

    第二に、粗利の構造が違う。これはすでに業界で確立しつつある視点だが、生成AIアプリは推論コスト——LLM の API やコンピュート——が売上原価(COGS)に乗る。生成AI以前から、AI/ML企業は従来SaaSより粗利が低くなりやすいという論点は指摘されていた。a16z は2020年の時点で、AI企業の粗利をおおむね50〜60%程度、従来SaaSを60〜80%超と観察していた。本稿ではこれを「LLM原価後粗利」、すなわち推論原価を引いた後に残る粗利として捉えたい。ARR が同じでも、原価を引いた後に何が残るかは大きく異なる。ただし Bain Capital Ventures が「粗利だけを見るな」と論じるように、推論単価は時間とともに下がり粗利は改善しうるため、ある時点の粗利を過度に重視するのも誤りである。

    この二つを踏まえると、埋め込みの深さを読むための補助線がほしくなる。本稿では、既存の指標に連なる二つの視点を提案したい。

    一つは「顧客内展開率」。これは SaaS で確立した NRR や expansion rate——一顧客のなかで利用がどれだけ広がるか——に連なる考え方を、Enterprise AI 向けに読み替えたものだ。一社のなかで部署を超えて使われ、業務に食い込んでいくほど、その収益は剥がれにくく、埋め込みが深いことの証になる。

    もう一つは「テンプレート再利用率」。こちらは業界標準の指標ではなく、ABF が提案する作業仮説に近い。FDE的な実装は、当初こそ一社ごとの作り込みだが、その実装をどれだけ型(テンプレート)として再利用し、次の顧客へ展開できているか——サービスがプロダクトへ転化できているかを測る目安になる。再利用率が高ければ、低マージンの実装が、将来スケールする資産へ変わりつつあるサインと読める。

    これら三つは、どれも「埋め込み資産が、どれだけ製品化され、深まり、剥がれにくくなっているか」を別々の角度から照らす。資本が生成AI企業を評価するとは、突き詰めればこの埋め込みの深さと再現困難さを読むことにほかならない。

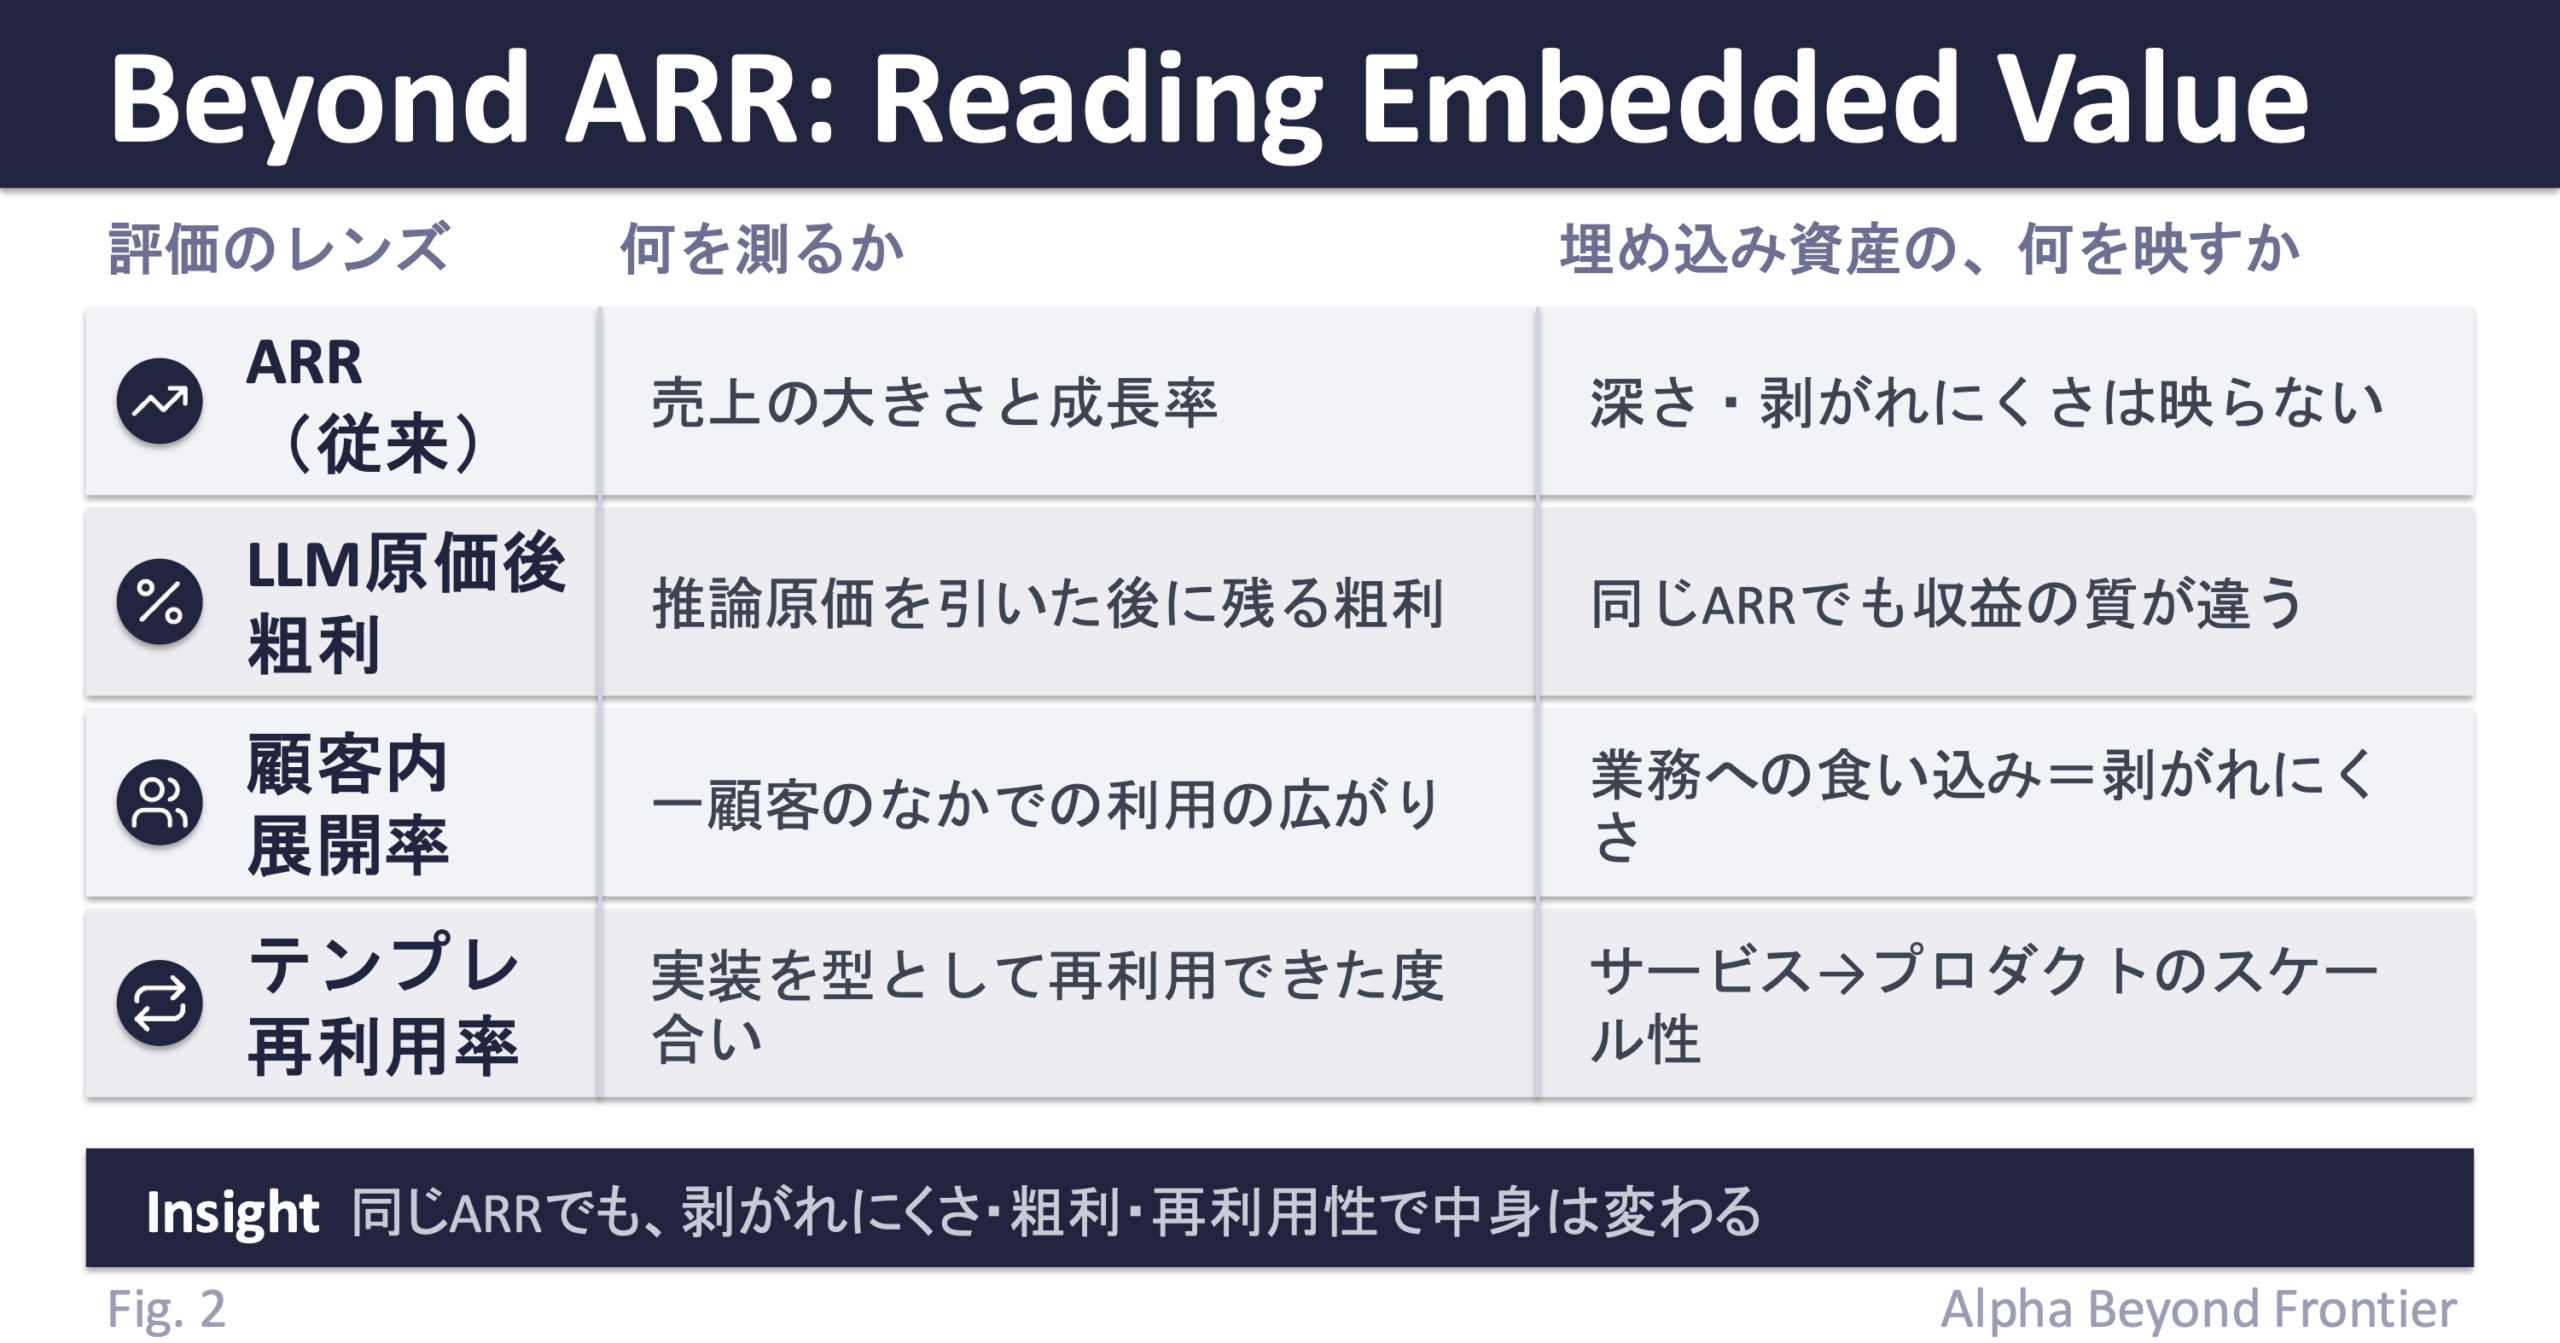
    図2: AI企業の価値を読む評価のレンズ。従来の中心であるARRは売上の大きさと成長を測るが、深さや剥がれにくさは映らない。①LLM原価後粗利は推論原価を引いた後に残る粗利、②顧客内展開率は一顧客のなかでの利用の広がり、③テンプレート再利用率は実装を型として再利用できた度合いを示し、それぞれ収益の質・業務への食い込み・サービスからプロダクトへのスケール性を映す。ARRの大きさより、埋め込みの深さを読む

    5. M&A——評価対象は技術から人材・データ・顧客基盤へ広がる

    埋め込み資産という視点は、M&Aの読み方も変える。

    2024年以降、Microsoft と Inflection、Amazon と Adept、Google と Character.AI のように、大手テックがスタートアップの中核チームを雇用しつつ、技術を非排他的にライセンスする——完全買収ではない「ライセンス+人材獲得」型のディールが、一つの類型として相次いで報じられた(いずれも報道ベース。なお Meta と Scale AI のように、少数出資と一部人材の移籍という、構造の異なる事例もある)。

    M&Aの実務側からも、価値の所在が動いていることがうかがえる。大手法律事務所 Skadden は2026年の解説で、AI企業の買収では価値の中核が「技術そのものよりも、鍵となる人材の確保」にある類型が現れていると指摘する。デューデリジェンスの重点も、モデルのベンチマーク上の性能以上に、学習データの権利と出所がどれだけ追跡可能か、中核ノウハウが少数の人材に集中していないか、そのモデルが実環境で性能を再現できるかへ移っているという。

    ただし、ここでも言い切りは避けたい。Databricks による MosaicML 買収のように、技術やプラットフォーム自体を主目的とする買収も実在する。実際には、技術と人材・実装力は分かちがたく結びついている。正確に言えばこうだ——AI企業のM&Aでは、技術そのものに加えて、データ、顧客基盤、業務知、そして実装済みのワークフローが評価対象になる。買い手が取りに来るのは、モデルそのものではなく、その企業が顧客の業務へ埋め込んできたものの総体である。

    6. 日本の Enterprise AI 企業は、海外の資本にどう見えるか

    最後に、この視点を日本に引きつけてみる。

    日本企業向けに深く入り込む Enterprise AI 企業が価値を作るとすれば、その源泉は日本市場の業務・規制・商習慣に特化したデータと顧客基盤になりやすい。これは前述の議論からすれば、まさに「埋め込み資産」である。だが、その価値は、誰が評価するかによって見え方が大きく変わる。ここに、見落とされがちな一つの逆転がある——同じ「ローカルな深さ」が、海外の投資家には割り引かれ、戦略的な買い手には価値として認識されるのだ。

    海外のVCにとって、日本市場に特化した深さは「読みにくい資産」に映りやすい。グローバルに横展開できるスケール性を重視する投資家から見れば、ローカルに最適化された深さは、市場の天井が低い「ローカルな堀」として割り引かれがちだ。言語と商習慣の壁もあって、その埋め込みがどれだけ深いのかを外から評価すること自体が難しい。

    ところが、同じ資産が、別の評価主体——たとえば事業会社や PE といった戦略的な買い手——には、むしろ高い価値として映ることがある。彼らにとっては、ある業界の業務に深く埋め込まれ、顧客が離れられない関係こそが、自前では作れない買収対象としての魅力になるからだ。同じ埋め込み資産でも、誰が値段をつけるかによって評価が反転する——これは日本の Enterprise AI 企業にとって、見過ごせない非対称である。

    ここに、日本の Enterprise AI 企業にとっての実務的な問いがある。自社の埋め込み資産を、グローバルなスケール性として語るのか、それとも特定領域での再現困難な深さとして語るのか。誰に価値を認識してもらうかによって、語り方も、組むべき資本の選び方も変わってくる。

    おわりに:競争は「最良のモデル」から「資本が認識できる埋め込み」へ

    生成AIの時代に、モデルそのものは差別化の中心ではなくなりつつある。価値は、業務に深く埋め込まれて持ち出せないもの——データ、業務フロー、暗黙知、実装力——へ移っていく。そして勝ち筋があるのは、判断集約的で、顧客固有のデータが蓄積し、業務に深く食い込む領域である。

    だが本稿が強調したいのは、その先だ。埋め込み資産は、ただ存在するだけでは価値にならない。資本市場がそれを価値として認識して、はじめて値段がつく。だからこそ、ARRの質、原価を引いた後の粗利、顧客内での展開、実装の再利用——埋め込みの深さと再現困難さを読むための物差しが要る。問いは「どの Vertical AI が勝つか」ではなく、「どの Vertical AI なら、資本市場で価値として認識されるのか」である。

    そしてこれは、評価する側にも跳ね返る。モデルでは測れない資産を読むには、投資家や買い手の側にも、業務への深い理解が要る——以前に本ブログで論じた「AIネイティブVC」の問いとも、ここでつながる。AIが価値の所在を「モデルの外側」へ動かすほど、それを正しく評価できる力そのものが、次の競争の焦点になる。

    References

    本ブログの関連記事